 Elastic Stack
AI 整理版
本篇已整理为更适合学习与复习的笔记结构,欢迎前往阅读:Elastic Stack-AI整理版。
Elastic Stack 简介
ELK是一个免费开源的日志分析架构技术栈总称,官网。包含三大基础组件,分别是Elasticsearch、Logstash、Kibana。但实际上ELK 不仅仅适用于日志分析,它还可以支持其它任何数据搜索、分析和收集的场景,日 志分析和收集只是更具有代表性。并非唯一性。下面是ELK架构:
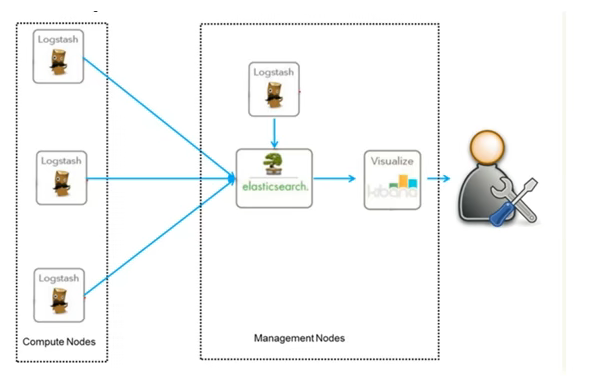
随着elk的发展,又有新成员Beats、elastic cloud的加入,所以就形成了 Elastic Stack。所以说,ELK是I旧的称呼,Elastic Stack是新的名字。

Elastic Stack特色
处理方式灵活:elasticsearch是目前最流行的准实时全文检索引擎,具有 高速检索大数据的能力。
配置简单:安装k的每个组件,仅需配置每个组件的一个配置文件即可。
修改处不多,因为大量参数已经默认配在系统中,修改想要修改的选项即 可。
接口简单:采用json形式RESTFUL API接受数据并响应,无关语言。
性能高效:elasticsearch:基于优秀的全文搜索技术Lucene,采用倒排索 引,可以轻易地在百亿级别数据量下,搜索出想要的内容,并且是秒级响 应。
灵活扩展:elasticsearchi和logstash都可以根据集群规模线性拓展, elasticsearch内部自动实现集群协作。
数据展现华丽:kibana作为前端展现工具,图表华丽,配置简单。
Elastic Stack组件介绍
Elasticsearch
Elasticsearch是使用java开发,基于Lucene、分布式、通过Restful)方式进行 交互的近实时搜索平台框架。它的特点有:分布式,零配置,自动发现,索引自动 分片,索引副本机制,restful风格接口,多数据源,自动搜索负载等。
Logstash
Logstash基于java开发,是一个数据抽取转化工具。一般工作方式为c/s架 构,clienti端安装在需要收集信息的主机上,serveri端负责将收到的各节点日志进 行过滤、修改等操作在一并发往elasticsearch或其他组件上去。
Kibana
Kibana基于nodejs,也是一个开源和免费的可视化工具。Kibanai可以为 Logstash和ElasticSearch提供的日志分析友好的Web界面,可以汇总、分析和 搜索重要数据日志。
Beats
Beats平台集合了多种单一用途数据采集器。它们从成百上千或成千上万台机 器和系统向Logstash或Elasticsearch发送数据。
Beats由如下组成
Packetbeat
轻量型网络数据采集器,用于深挖网线上传输的数据,了解应 用程序动态。Packetbeat是一款轻量型网络数据包分析器,能够将数据发送至 Logstash或Elasticsearch。其支持ICMP(v4andv6)、DNS、HTTP、Mysql.. PostgreSQL、Redis、MongoDB、Memcache等t协议。
Filebeat
轻量型日志采集器。当您要面对成百上千、甚至成千上万的服务 器、虚拟机和容器生成的日志时,请告别SSH吧。Filebeat将为您提供一种轻量型 方法,用于转发和汇总日志与文件,让简单的事情不再繁杂。
Metricbeat
轻量型指标采集器。Metricbeat能够以一种轻量型的方式, 输送各种系统和服务统计数据,从CPU到内存,从Redis到Nginx,不一而足。 可定期获取外部系统的监控指标信息,其可以监控、收集Apache http、 HAProxy、MongoDB、MySQL、Nginx、PostgreSQL、Redis、System Zookeeper等服务。
Winlogbeat
轻量型Windows事件日志采集器。用于密切监控基于 Windows的基础设施上发生的事件。Winlogbeat能够以一种轻量型的方式,将 Windows事件日志实时地流式传输至Elasticsearch和Logstash。
Auditbeat
轻量型审计日志采集器。收集您Linux审计框架的数据,监控 文件完整性。Auditbeat实时采集这些事件,然后发送到Elastic Stack其他部分做 进一步分析。
Heartbeat
面向运行状态监测的轻量型采集器。通过主动探测来监测服务 的可用性。通过给定URL列表,Heartbeat仅仅询问:网站运行正常吗? Heartbeat会将此信息和响应时间发送至Elastic的其他部分,以进行进一步分 析。
Functionbeat
面向云端数据的无服务器采集器。在作为一项功能部署在云 服务提供商的功能即服务(FaaS)平台上后,Functionbeat即能收集、传送并监测 来自您的云服务的相关数据。
Elastic cloud
基于Elasticsearch的软件即服务(Saas)解决方案。通过Elastic的官方合作伙 伴使用托管的Elasticsearch服务。
Elasticsearch是什么
搜索是什么?
概念:用户输入想要的关键词,返回含有该关键词的所有信息。 场景:
- 互联网搜索:谷歌、百度、各种新闻首页;
- 站内搜索(垂直搜索):企业OA查询订单、人员、部门,电商网站内部搜索商品(淘宝、京东)场景。
数据库做搜索弊端
站内搜索(垂直搜索)
数据量小,简单搜索,可以使用数据库。
问题出现
存储问题。
电商网站商品上亿条时,涉及到单表数据过大必须拆分表,数据 库磁盘占用过大必须分库(mycat)。
性能问题。
解决上面问题后,查询“笔记本电脑”等关键词时,上亿条数据的 商品名字段逐行扫描,性能跟不上。
不能分词。
如搜索“笔记本电脑”,只能搜索完全和关键词一样的数据,那么 数据量小时,搜索“笔记电脑”,“电脑"数据要不要给用户。
总结
互联网搜索,肯定不会使用数据库搜索。数据量太大。PB级。
全文检索、倒排索引和Lucene
全文检索
倒排索引。数据存储时,经行分词建立term索引库。
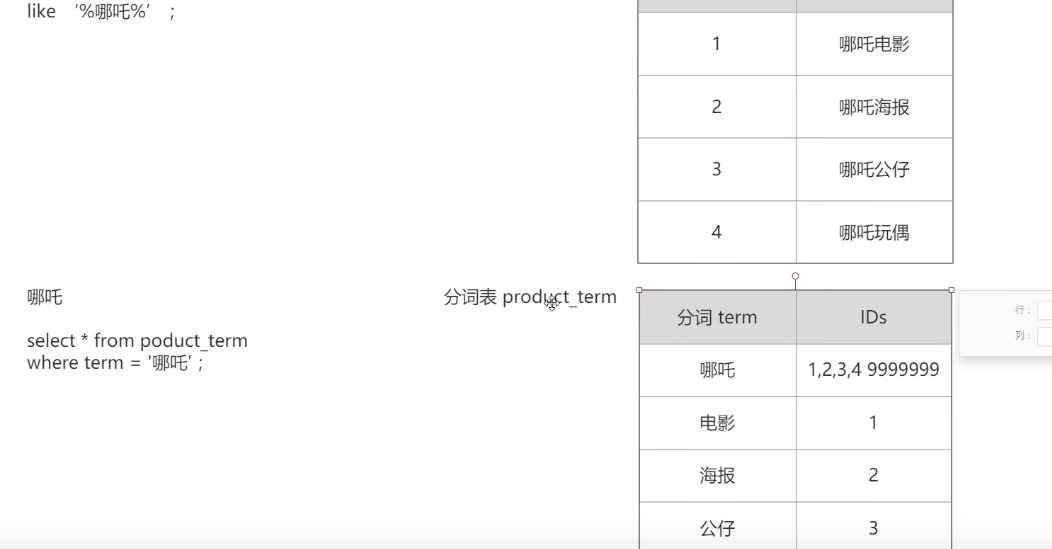
倒排索引源于实际应用中需要根据属性的值来查找记录。这种索引表中的每一 项都包括一个属性值和具有该属性值的各记录的地址。由于不是由记录来确定属性 值,而是由属性值来确定记录的位置,因而称为倒排索引(inverted index)。带有倒 排索引的文件我们称为倒排索引文件,简称倒排文件(inverted file)。
Lucene
就是一们r包,里面封装了全文检索的引擎、搜索的算法代码。开发时,引入 lucenel的jar包,通过api开发搜索相关业务。底层会在磁盘建立索引库。
什么是Elasticsearch
简介
ElasticSearch:是一个基于Lucene的搜索服务器。它提供了一个分布式多用户 能力的全文搜索引擎,基于RESTful web 接口。 官网
Elasticsearch的功能
分布式的搜索引擎和数据分析引
搜索:互联网搜索、电商网站站内搜索、OA系统查询 数据分析:电商网站查询近一周哪些品类的图书销售前十:新闻网站,最近3 天阅读量最高的十个关键词,舆情分析。
全文检索,结构化检索,数据分析 全文检索:搜索商品名称包含java的图书selectfrom books where book_name like "%java%" 结构化检索:搜索商品分类为spring的图书都有哪些,selectfrom books where category_id='spring' 数据分析:分析每一个分类下有多少种图书,select category_id,count(*) from books group by category_id
对海量数据进行近实时的处理 分布式:ES自动可以将海量数据分散到多台服务器上去存储和检索,经行并行查 询,提高搜索效率。相对的,Lucene是单机应用。 近实时:数据库上亿条数据查询,搜索一次耗时几个小时,是批处理(batch- processing)。而es只需秒级即可查询海量数据,所以叫近实时。秒级。
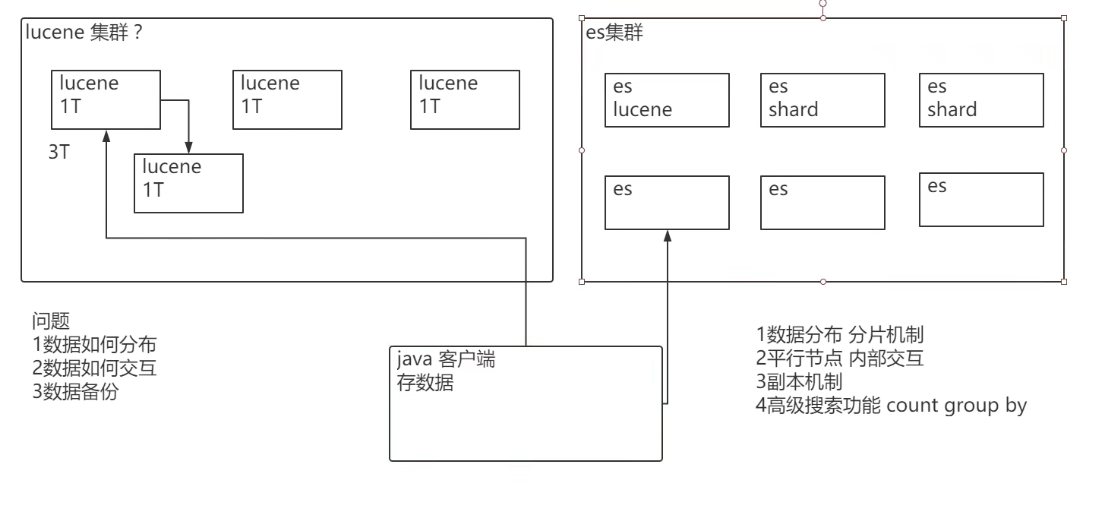
Elasticsearch 的使用场景
国外:
- 维基百科,类似百度百科,“网络七层协议"的维基百科,全文检索,高亮, 搜索推荐
- Stack Overflow(国外的程序讨论论坛),相当于程序员的贴吧。遇到it问 题去上面发帖,热心网友下面回帖解答。
- GitHub(开源代码管理),搜索上千亿行代码。
- 电商网站,检索商品
- 日志数据分析,logstash采集日志,ES进行复杂的数据分析(ELK技术, elasticsearch+logstash+kibana
- 商品价格监控网站,用户设定某商品的价格阈值,当低于该阈值的时候,发 送通知消息给用户,比如说订阅《jva编程思想》的监控,如果价格低于 27块钱,就通知我,我就去买。
- BI系统,商业智能(Business Intelligence)。大型连锁超市,分析全国网 点传回的数据,分析各个商品在什么季节的销售量最好、利润最高。成本管 理,店面租金、员工工资、负债等信息进行分析。从而部署下一个阶段的战 略目标。
国内:
- 百度搜索,第一次查询,使用es。
- OA、ERP系统站内搜索。
Elasticsearch的特点
- 可拓展性:大型分布式集群(数百台服务器)技术,处理PB级数据,大公 司可以使用。小公司数据量小,也可以部署在单机。大数据领域使用广泛。
- 技术整合:将全文检索、数据分析、分布式相关技术整合在一起: lucene(全文检索),商用的数据分析软件(B软件),分布式数据库 mycat
- 部署简单:开箱即用,很多默认配置不需关心,解压完成直接运行即可。拓 展时,只需多部署几个实例即可,负载均衡、分片迁移集群内部自己实施。
- 接口简单:使用restful api经行交互,跨语言。
- 功能强大:Elasticsearch作为传统数据库的一个补充,提供了数据库所不不 能提供的很多功能,如全文检索,同义词处理,相关度排名。
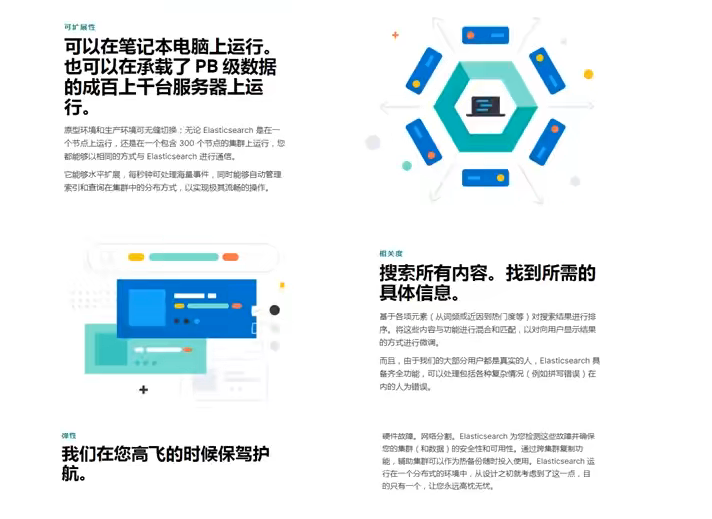
Elasticsearch 的核心概念
lucene和elasticsearch的关系
Lucene:最先进、功能最强大的搜索库,直接基于lucene开发,非常复杂, api复杂。 Elasticsearch:基于lucene,封装了许多ucene底层功能,提供简单易用的 restful api接口和许多语言的客户端,如java的高级客户端(Java High Level REST Client)和底层客户端(Java Low Level REST Client)
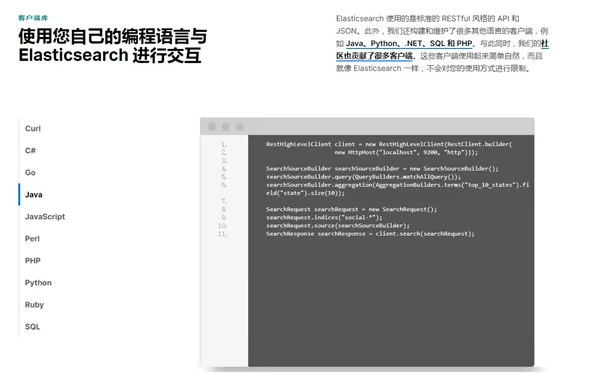
起源:Shay Banon。2004年失业,陪老婆去伦敦学习厨师。失业在家帮老婆 写一个菜谱搜索引擎。封装了lucenet的开源项目,compass。找到工作后,做分布 式高性能项目,再封装compass,写出了elasticsearch,使得lucene,使得lucenet支持分布式。 现在是Elasticsearch创始人兼Elastic首席执行官。
Elasticsearch 的核心概念
1 NRT(Near Realtime):近实时
- 两方面: 写入数据时,过1秒才会被搜索到,因为内部在分词、录入索引。
- es搜索时:搜索和分析数据需要秒级出结果。
2 Cluster:集群
包含一个或多个启动着es实例的机器群。通常一台机器起一个es实例。同一网 络下,集名一样的多个s实例自动组成集群,自动均衡分片等行为。默认集群名 为"elasticsearch"。
3 Node:节点
每个s实例称为一个节点。节点名自动分配,也可以手动配置。
4 Document:文档
es中的最小数据单元。一个documenti就像数据库中的一条记录。通常以)json 格式显示。多个document存储于一个索引(Index)中。
book document

{
    "book_id":"1",
	"book_name":"java编程思想",
	"book_desc":"从Java的基础语法到最高级特性(深入的[面向对象](https://baike.baidu.com/item/面向对象)概念、多线程、自动项目构	建、单元测试和调试等),本书都能逐步指导你轻松学握。”,
	"category_id":"2",
	"category_name":"java"
}
5 Index:索引
包含一堆有相似结构的文档数据。 索引创建规则:
- 仅限小写字母
- 不能包含1、/、*、?、"、<、>、、#以及空格符等特殊符号
- 从7.0版本开始不再包含冒号
- 不能以、或+开头
- 不能超过255个字节(注意它是字节,因此多字节字符将计入255个限制)
6 Field:字段
就像数据库中的列(Columns),定义每个document)应该有的字段。
7Type:类型
每个索引里都可以有一个或多个type,type是index中的一个逻辑数据分类, 一个type下的document,都有相同的field。 注意:6.0之前的版本有type(类型)概念,type相当于关系数据库的表,ES 官方将在ES9.0版本中彻底删除type。本教程ypy都为_doc。
8 shard:分片
index数据过大时,将index.里面的数据,分为多个shard,分布式的存储在各 个服务器上面。可以支持海量数据和高并发,提升性能和吞吐量,充分利用多台机 器的cpu。
9 replica:副本
在分布式环境下,任何一台机器都会随时宕机,如果宕机,index的一个分片 没有,导致此index不能搜索。所以,为了保证数据的安全,我们会将每个index的 分片经行备份,存储在另外的机器上。保证少数机器宕机s集群仍可以搜索。
能正常提供查询和插入的分片我们叫做主分片(primary shard),其余的我 们就管他们叫做备份的分片(replica shard)。
s6默认新建索引时,5分片,1副本,也就是一主一备,共10个分片。所以, es集群最小规模为两台。es71分片,1副本,一共2分片。
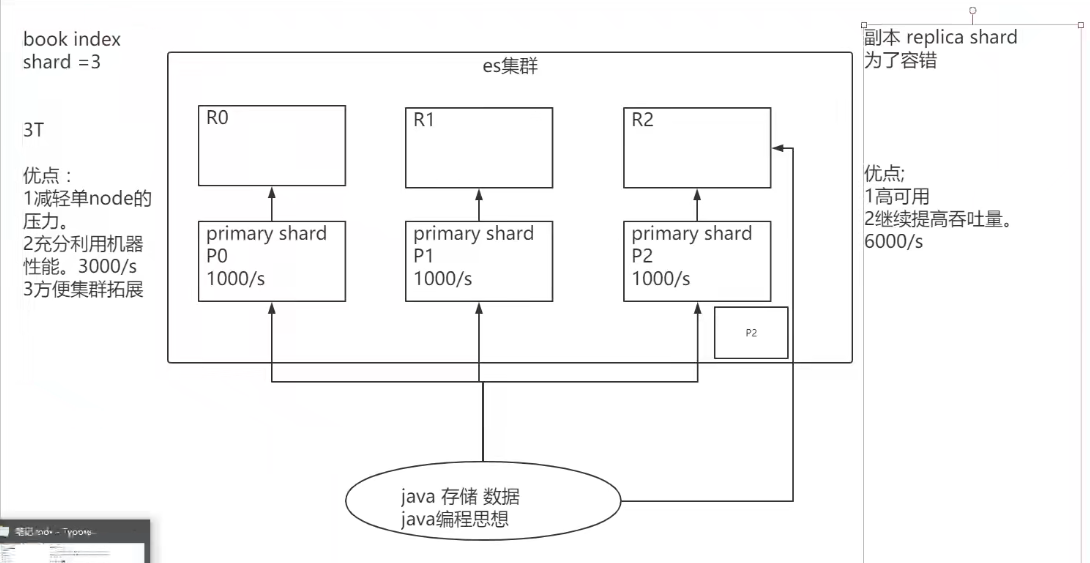
数据库核心概念vs.elasticsearch核心概念
| 关系型数据库(比如Mysql) | 非关系型数据库(Elasticsearch) |
|---|---|
| 数据库Database | 索引Index |
| 表Table | 索引Index(原为Type) |
| 数据行Rod | 文档Document |
| 数据列Column | 字段Field |
| 约束Schema | 映射Mapping |
es快速入门
商品的CRUD
1. 创建图书索引
语法:PUT /index
请求参数:
put /book响应结果:
{
  "acknowledged" : true,
  "shards_acknowledged" : true,
  "index" : "book"
}
2. 新增图书:新增文档
语法:PUT /index/type/id
请求参数
put /book/_doc/1
{
    "name": "Bootstrap开发",
    "description": "Bootstrap是由witter:推出的一个前台页面开发css框架,是一个非常流行的开发框架,此框架集成了多种页面效果。此开发框架包含了大量的CSS、S程序代码,可以帮助开发者(尤其是不擅长css页面开发的程序人员)轻松的实现一个Css,不受浏览器限制的精美界面css效果。",
    "studymodel": "201002",
    "price": 38.6,
    "timestamp": "2019-08-2519:11:35",
    "pic": "group1/M00/00/00/wKh1QFs6RCeAYOpHAAJx5ZjNDEM428.jpg",
    "tags": [
        "bootstrap",
        "dev"
    ]
}
响应结果
{
  "_index" : "book",
  "_type" : "_doc",
  "_id" : "1",
  "_version" : 1,
  "result" : "created",
  "_shards" : {
    "total" : 2,
    "successful" : 1,
    "failed" : 0
  },
  "_seq_no" : 0,
  "_primary_term" : 1
}
3. 根据_id查询图书:查询文档
语法:GET/index/type/id
请求参数
get /book/_doc/1响应结果,存在
{
  "_index" : "book",
  "_type" : "_doc",
  "_id" : "1",
  "_version" : 1,
  "_seq_no" : 0,
  "_primary_term" : 1,
  "found" : true,
  "_source" : {
    "name" : "Bootstrap开发",
    "description" : "Bootstrap是由witter:推出的一个前台页面开发css框架,是一个非常流行的开发框架,此框架集成了多种页面效果。此开发框架包含了大量的CSS、S程序代码,可以帮助开发者(尤其是不擅长css页面开发的程序人员)轻松的实现一个Css,不受浏览器限制的精美界面css效果。",
    "studymodel" : "201002",
    "price" : 38.6,
    "timestamp" : "2019-08-2519:11:35",
    "pic" : "group1/M00/00/00/wKh1QFs6RCeAYOpHAAJx5ZjNDEM428.jpg",
    "tags" : [
      "bootstrap",
      "dev"
    ]
  }
}
响应结果不存在
{
  "_index" : "book",
  "_type" : "_doc",
  "_id" : "2",
  "found" : false
}
4. 覆盖指定_id的图书:覆盖文档
语法:PUT /index/type/id
请求参数:
put /book/_doc/1
{
    "name": "Bootstrap开发1",
    "description": "Bootstrap是由witter:推出的一个前台页面开发css框架,是一个非常流行的开发框架,此框架集成了多种页面效果。此开发框架包含了大量的CSS、S程序代码,可以帮助开发者(尤其是不擅长css页面开发的程序人员)轻松的实现一个Css,不受浏览器限制的精美界面css效果。",
    "studymodel": "201002",
    "price": 38.6,
    "timestamp": "2019-08-2519:11:35",
    "pic": "group1/M00/00/00/wKh1QFs6RCeAYOpHAAJx5ZjNDEM428.jpg",
    "tags": [
        "bootstrap",
        "dev",
        "js"
    ]
}
响应结果:
{
  "_index" : "book",
  "_type" : "_doc",
  "_id" : "1",
  "_version" : 2,
  "result" : "updated",
  "_shards" : {
    "total" : 2,
    "successful" : 1,
    "failed" : 0
  },
  "_seq_no" : 1,
  "_primary_term" : 1
}
5. 修改指定_id的图书局部内容:修改文档
语法:POST /index/type/id/_update
请求参数:
post /book/_doc/1/_update
{
    "doc": {
        "name": "Bootstrap开发_update",
        "tags": [
            "bootstrap",
            "dev",
            "update"
        ]
    }
}
响应结果:
#! Deprecation: [types removal] Specifying types in document update requests is deprecated, use the endpoint /{index}/_update/{id} instead.
{
  "_index" : "book",
  "_type" : "_doc",
  "_id" : "1",
  "_version" : 2,
  "result" : "updated",
  "_shards" : {
    "total" : 2,
    "successful" : 1,
    "failed" : 0
  },
  "_seq_no" : 1,
  "_primary_term" : 1
}
它提示可以改为:
语法:POST /index/_update/id
请求参数:
post /book/_update/1
{
    "doc": {
        "name": "Bootstrap开发_update2",
        "tags": [
            "bootstrap",
            "dev"
        ]
    }
}
响应结果:
{
  "_index" : "book",
  "_type" : "_doc",
  "_id" : "1",
  "_version" : 2,
  "result" : "updated",
  "_shards" : {
    "total" : 2,
    "successful" : 1,
    "failed" : 0
  },
  "_seq_no" : 1,
  "_primary_term" : 1
}
6. 删除图书:删除文档
语法:DELETE /index/type/id
请求参数:
DELETE /book/_doc/1响应结果:
{
  "_index" : "book",
  "_type" : "_doc",
  "_id" : "1",
  "_version" : 2,
  "result" : "deleted",
  "_shards" : {
    "total" : 2,
    "successful" : 1,
    "failed" : 0
  },
  "_seq_no" : 1,
  "_primary_term" : 1
}
文档Document入门
默认的自带字段解析
{
  "_index" : "book",
  "_type" : "_doc",
  "_id" : "1",
  "_version" : 1,
  "_seq_no" : 0,
  "_primary_term" : 1,
  "found" : true,
  "_source" : {
    "name" : "Bootstrap开发",
    "description" : "Bootstrap是由witter:推出的一个前台页面开发css框架,是一个非常流行的开发框架,此框架集成了多种页面效果。此开发框架包含了大量的CSS、S程序代码,可以帮助开发者(尤其是不擅长css页面开发的程序人员)轻松的实现一个Css,不受浏览器限制的精美界面css效果。",
    "studymodel" : "201002",
    "price" : 38.6,
    "timestamp" : "2019-08-2519:11:35",
    "pic" : "group1/M00/00/00/wKh1QFs6RCeAYOpHAAJx5ZjNDEM428.jpg",
    "tags" : [
      "bootstrap",
      "dev"
    ]
  }
}
_index
- 含义:此文档属于哪个索引。
- 原则:类似数据放在一个索引中。数据库中表的定义规则。如图书信息放在00k索。
- 引中,员工信息放在employee索引中。各个索存储和搜索时互不影响。 定义规则:英文小写。尽呈不要使用特殊字符。order user
_type
- 含义:类别。book java node。
- 注意:以后的es9将彻底册除此字段,所以当前版本在不断弱化type。不需要关 注。见到type都为doc。
_id
- 含义:文档的唯一标识。就像表的id主键。结合索引可以标识和定义一个文档。
- 生成:手动(put /index/_doc/id)、自动。
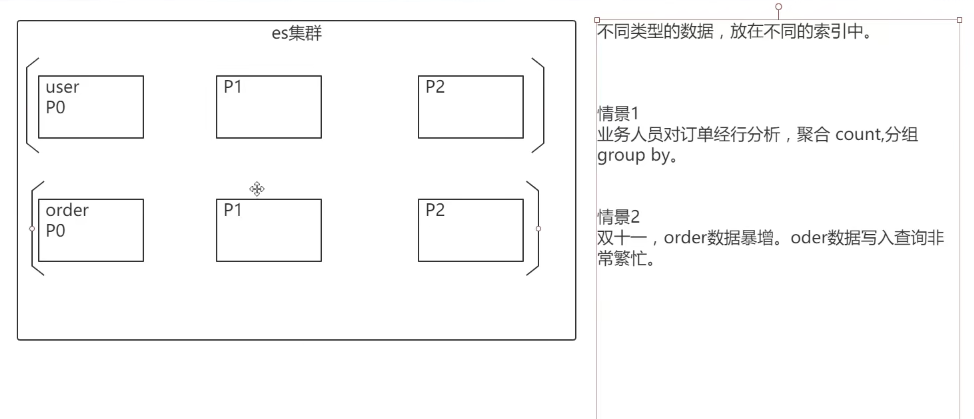
创建索引时,不同数据放到不同索引中
生成文档id
手动生成id
参考[2. 新增图书:新增文档](#2. 新增图书:新增文档)
自动生成id
白动id特点: 长度为20个字符,URL安全,base64编码,GUID,分布式生成不冲突。
语法:POST /index/type
请求入参:
POST /test_index/_doc
{
  "test_field": "demo"
}
响应结果:
{
  "_index" : "test_index",
  "_type" : "_doc",
  "_id" : "Fn28zYQBMWSYG3VSxZy0",
  "_version" : 1,
  "result" : "created",
  "_shards" : {
    "total" : 2,
    "successful" : 1,
    "failed" : 0
  },
  "_seq_no" : 0,
  "_primary_term" : 1
}
_source字段
_source
含义:插入数据时的所有字段和值。在ge获取数据时,在_source:字段中原样返回。 GET /book/doc/1
6.3.2定制返回字段
就像sql不要select*,而要select name,.price from book,一样。
返回所有:GET /book/_doc/1
{
  "_index" : "book",
  "_type" : "_doc",
  "_id" : "1",
  "_version" : 1,
  "_seq_no" : 0,
  "_primary_term" : 1,
  "found" : true,
  "_source" : {
    "name" : "Bootstrap开发",
    "description" : "Bootstrap是由witter:推出的一个前台页面开发css框架,是一个非常流行的开发框架,此框架集成了多种页面效果。此开发框架包含了大量的CSS、S程序代码,可以帮助开发者(尤其是不擅长css页面开发的程序人员)轻松的实现一个Css,不受浏览器限制的精美界面css效果。",
    "studymodel" : "201002",
    "price" : 38.6,
    "timestamp" : "2019-08-2519:11:35",
    "pic" : "group1/M00/00/00/wKh1QFs6RCeAYOpHAAJx5ZjNDEM428.jpg",
    "tags" : [
      "bootstrap",
      "dev"
    ]
  }
}
定制返回字段: GET /book/_doc/1?_source_includes=name,price
{
    "_index": "book",
    "_type": "_doc",
    "_id": "1",
    "_version": 1,
    "_5eq_-no": 10,
    "_primary_term": 1,
    "found": true,
    "_source": {
        "price": 38.6,
        "name": "Bootstrap开发牧程1"
    }
}
文档的替换与删除
全量替换
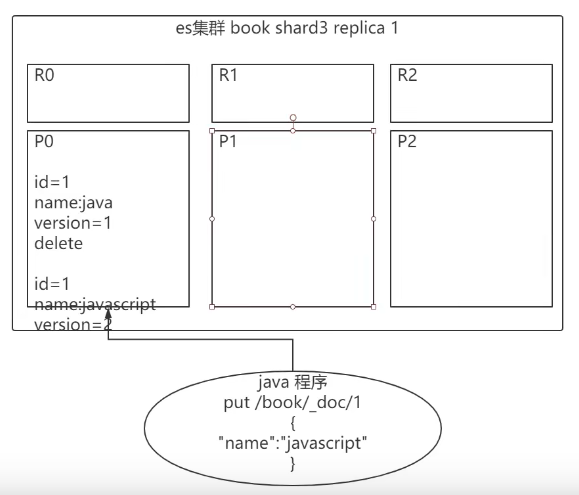
执行两次,返回结果中版本号(version)在不断上升。此过程为全量替换。
PUT /test_index/_doc/1
{
    "test_field":"test"
}
实质:旧文档的内容不会立即删除,只是标记为deleted。适当的时机,集群会将这些文档删除。
强制创建
为防止覆盖原有数据,我们在新增时,设置为强制创建,不会覆盖原有文档。
可以用于数据库同步数据,这样可以确保数据只插入一次不会重复插入或覆盖。
语法:PUT /index/_doc/id/_create请求入参:
PUT /test_index/_doc/1/_create
{
    "test_field":"test"
}
第一次请求响应结果:
{
  "_index" : "test_index",
  "_type" : "_doc",
  "_id" : "1",
  "_version" : 1,
  "result" : "created",
  "_shards" : {
    "total" : 2,
    "successful" : 1,
    "failed" : 0
  },
  "_seq_no" : 1,
  "_primary_term" : 1
}
再次请求(存在数据)响应结果:
{
  "error" : {
    "root_cause" : [
      {
        "type" : "version_conflict_engine_exception",
        "reason" : "[1]: version conflict, document already exists (current version [1])",
        "index_uuid" : "ej29cxPQQ3ab2t8_U0hMkg",
        "shard" : "0",
        "index" : "test_index"
      }
    ],
    "type" : "version_conflict_engine_exception",
    "reason" : "[1]: version conflict, document already exists (current version [1])",
    "index_uuid" : "ej29cxPQQ3ab2t8_U0hMkg",
    "shard" : "0",
    "index" : "test_index"
  },
  "status" : 409
}
局部更新partial update
使用PUT/index/ype/id为文档全量替换,需要将文档所有数据提交。 partial update 局部替换则只修改变动字段。 用法:
post /index/type/id/_update
{
    "doc": {
        "field": "value"
    }
}
图解内部原理
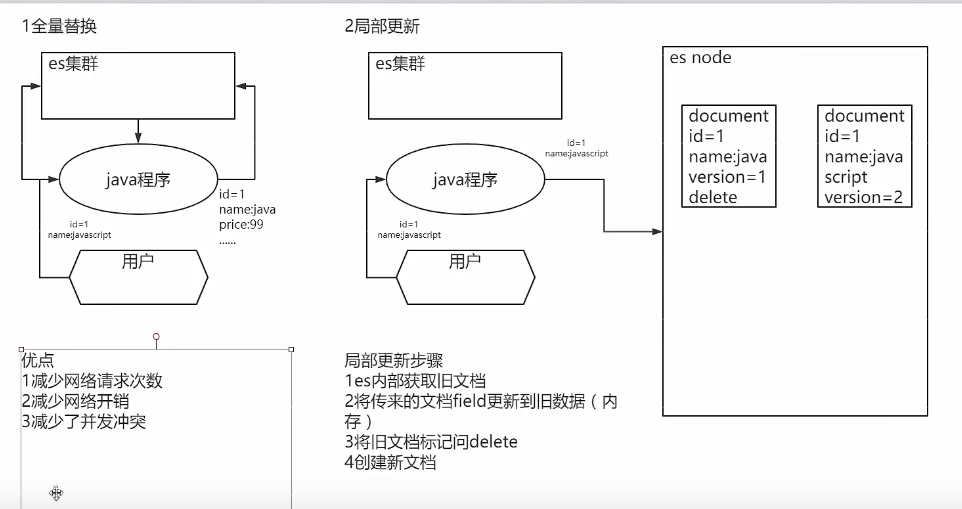
内部与全量替换是一样的,旧文档标记为删除,新建一个文档。 优点:
- 大大减少网络传输次数和流量,提升性能。
- 减少并发冲突发生的概率。
演示
[2. 新增图书:新增文档](#2. 新增图书:新增文档)
[5. 修改指定_id的图书局部内容:修改文档](#5. 修改指定_id的图书局部内容:修改文档)
使用脚本更新
es可以内置脚本执行复杂操作。例如painless脚本。 注意:groovy脚本在s6以后就不支持了。原因是耗内存,不安全远程注入漏洞。
内置脚本
需求1:修改文档6的num字段,+1。
插入数据:
PUT /test_index/_doc/6
{
    "num": 0
}
执行脚本操作:
POST /test_index/_doc/6/_update
{
    "script": "ctx._source.num+=1"
}
响应结果:
#! Deprecation: [types removal] Specifying types in document update requests is deprecated, use the endpoint /{index}/_update/{id} instead.
{
  "_index" : "test_index",
  "_type" : "_doc",
  "_id" : "6",
  "_version" : 2,
  "result" : "updated",
  "_shards" : {
    "total" : 2,
    "successful" : 1,
    "failed" : 0
  },
  "_seq_no" : 3,
  "_primary_term" : 1
}
查询数据:
GET /test_index/_doc_6响应结果:
{
  "_index" : "test_index",
  "_type" : "_doc",
  "_id" : "6",
  "_version" : 3,
  "_seq_no" : 4,
  "_primary_term" : 1,
  "found" : true,
  "_source" : {
    "num" : 1
  }
}
需求2:搜索所有文档,将num字段乘以2输出。
插入数据:
PUT /test_index/_doc/7
{
    "num": 5
}
查询:
GET /test_index/_search
{
    "script_fields": {
        "my_doubled_field": {
            "script": {
                "lang": "expression",
                "source": "doc['num'] * multiplier",
                "params": {
                    "multiplier": 2
                }
            }
        }
    }
}
响应结果:
{
  "took" : 33,
  "timed_out" : false,
  "_shards" : {
    "total" : 1,
    "successful" : 1,
    "skipped" : 0,
    "failed" : 0
  },
  "hits" : {
    "total" : {
      "value" : 4,
      "relation" : "eq"
    },
    "max_score" : 1.0,
    "hits" : [
      {
        "_index" : "test_index",
        "_type" : "_doc",
        "_id" : "Fn28zYQBMWSYG3VSxZy0",
        "_score" : 1.0,
        "fields" : {
          "my_doubled_field" : [
            0.0
          ]
        }
      },
      {
        "_index" : "test_index",
        "_type" : "_doc",
        "_id" : "1",
        "_score" : 1.0,
        "fields" : {
          "my_doubled_field" : [
            0.0
          ]
        }
      },
      {
        "_index" : "test_index",
        "_type" : "_doc",
        "_id" : "6",
        "_score" : 1.0,
        "fields" : {
          "my_doubled_field" : [
            4.0
          ]
        }
      },
      {
        "_index" : "test_index",
        "_type" : "_doc",
        "_id" : "7",
        "_score" : 1.0,
        "fields" : {
          "my_doubled_field" : [
            10.0
          ]
        }
      }
    ]
  }
}
外部脚本
Bainless是内置支持的。脚本内容可以通过多种途径传给es,包括rest接口,或者放
到config/scripts目录等,默认开启。
注意:脚本性能低下,且容易发生注入,本教程忽略。
官方文档:https://www.elastic.co/guide/en/elasticsearch/reference/current/modules-scripting-using.html
图解ES的并发问题
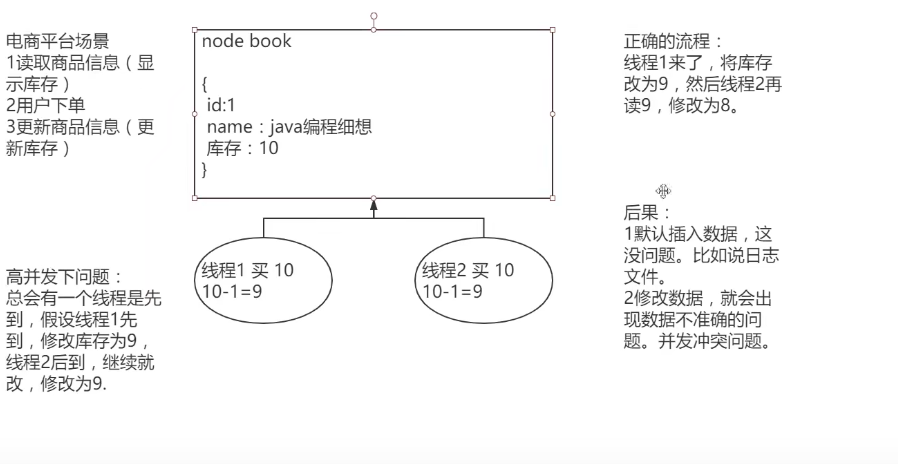
如同秒杀场景,多线程情况下,ES同样会出现并发冲突问题。
图解悲观锁与乐观锁机制
为控制并发问题,我们通常采用锁机制。分为悲观锁和乐观锁两种机制。
悲观锁:很悲观,所有情况都上锁。此时只有一个线程可以操作数据。具体例子为
数据库中的行级锁、表级锁、读锁、写锁等。
特点:优点是方便,直接加锁,对程序透明。缺点是效率低。
乐观锁:很乐观,对数据本身不加锁。提交数据时,通过一种机制验证是否存在冲
突,如es中通过版本号验证。
特点:优点是并发能力高。缺点是操作繁琐,在提交数据时,可能反复重试多次。
图解es内部基于_version乐观锁控制
实验基于_version的版本控制
es对于文档的增刷改都是基于版本号。
新增多次文档:
PUT /test_index/_doc/3
{
	"test_field":"test"
}
返回版本号递增:
// 新增第一次
{
  "_index" : "test_index",
  "_type" : "_doc",
  "_id" : "3",
  "_version" : 1,
  "result" : "created",
  "_shards" : {
    "total" : 2,
    "successful" : 1,
    "failed" : 0
  },
  "_seq_no" : 6,
  "_primary_term" : 2
}

// 新增第二次
{
  "_index" : "test_index",
  "_type" : "_doc",
  "_id" : "3",
  "_version" : 2,
  "result" : "updated",
  "_shards" : {
    "total" : 2,
    "successful" : 1,
    "failed" : 0
  },
  "_seq_no" : 9,
  "_primary_term" : 2
}
删除此文档:
DELETE /test_index/_doc/3响应结果:
{
  "_index" : "test_index",
  "_type" : "_doc",
  "_id" : "3",
  "_version" : 2,
  "result" : "deleted",
  "_shards" : {
    "total" : 2,
    "successful" : 1,
    "failed" : 0
  },
  "_seq_no" : 7,
  "_primary_term" : 2
}
即使是删除,也可以看到版本号依然递增,验证延迟删除策略。 如果除一条数据立马删除的话,所有分片和副本都要立马刷除,对s集群压力太 大。
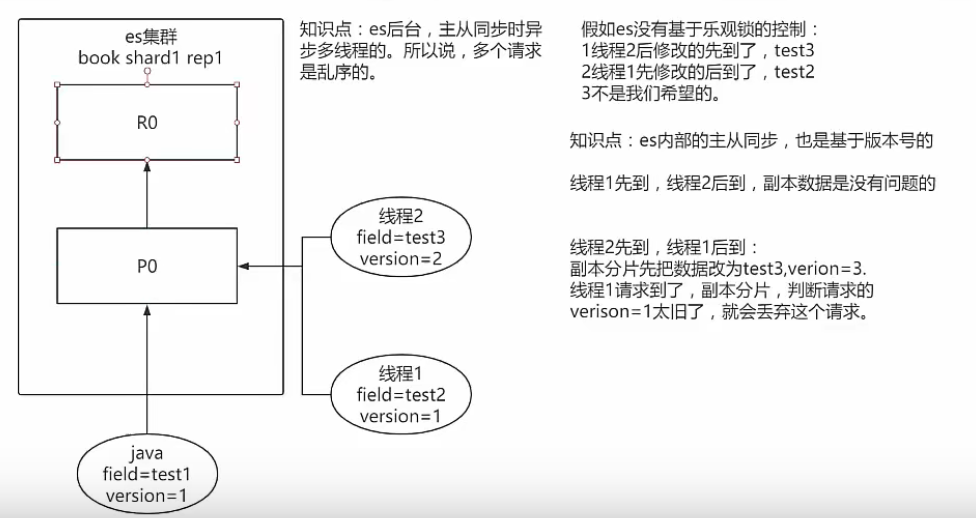
图解es内部主从同步并发控制
es内部主从同步时,是多线程异步。乐观锁机制。
批量增删改 bulk
Buk操作解释将文档的增删改查一些列操作,通过一次请求全都做完。减少网络传输
次数。
语法:
POST /_bulk
{"action":{"metadata"}}
{"data"}
如下操作,删除5,新增14,修改2。
POST /_bulk
{"create":{"_index":"test_index","_id":"8"}}
{"test_field":"test8"}
{"update":{"_index":"test_index","_id":"3"}}
{"doc":{"test_field":"bulk test"}}
{"delete":{"_index":"test_index","_id":"5"}}
总结:
功能:
- delete:删除一个文档,只要1个json串就可以了;
- create:相当于强制创建PUT /index/type/id/_create;
- index:普通的put操作,可以是创建文档,也可以是全量替换文档;
- update:执行的是局部更新partial update操作;
格式:每个json不能换行。相邻json必须换行。
隔离:每个操作互不影响。操作失败的行会返回其失败信息。
实际用法:buk请求一次不要太大,否则一下积压到内存中,性能会下降。所
以,一次请求几干个操作、大小在几M正好。
Java API 实现文档管理
elasticsearch java API
之前写的整合博客。
CSDN:(71条消息) spring-boot 整合elasticsearch 7.x(简单入门含gitee源码)_meng前行的博客-CSDN博客_springboot整合elasticsearch7
简书:spring-boot 整合elasticsearch 7.x(简单入门含gitee源码) - 简书 (jianshu.com)
图解es内部机制
图解es分布式基础
视频
day2-09-图解es分布式基础_哔哩哔哩_bilibili
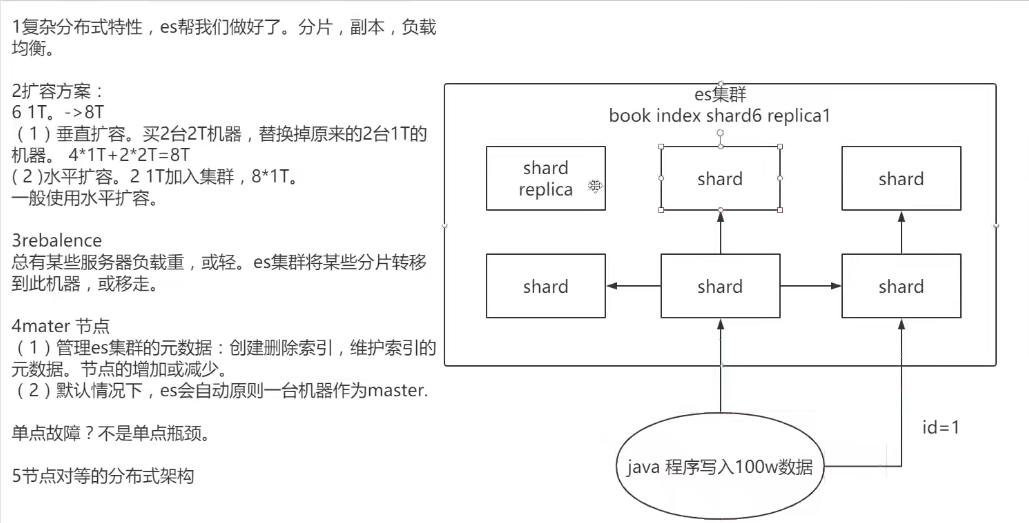
es对复杂分布式机制的透明隐藏特性
- 分布式机制:分布式数据存储及共享。
- 分片机制:数据存储到哪个分片,副本数据写入。
- 集群发现机制:cluster discovery。新启动es实例,自动加入集群。
- shard负载均衡:大呈数据写入及查询,es会将数据平均分配。
- shard副本:新增副本数,分片重分配。
Elasticsearch的垂直扩容与水平扩容
垂直扩容:使用更加强大的服务器替代老服务器。但单机存储及运算能力有上线。
且成本直线上升。如10t服务器1万。单个10T服务器可能20万。
水平扩容:采购更多服务器,加入集群。大数据。
增减或减少节点时的数据rebalance
新增或减少es实例时,es集群会将数据重新分配。
master节点
功能:
- 创建别除节点;
- 创建删除索引;
节点对等的分布式架构
- 节点对等,每个节点都能接收所有的请求;
- 自动请求路由;
- 响应收集;
示例图
图解分片shard、副本replica机制
视频
day2-10-图解分片shard、副本replica机制_哔哩哔哩_bilibili
shard & replica机制
每个index包,含一个或多个shard。
每个shard都是一个最小工作单元,承载部分数据,lucene实例,完整的建立
索引和处理请求的能力。
增减节点时,shard会自动在nodes中负载均衡。
primary shardi和replica shard,每个document肯定只存在于某一个primary shard以及其对应的replica shard中,不可能存在于多个primary shard。
replica shard,是primary shard的副本,负责容错,以及承担读请求负载。
primary shard的数量在创建索引的时候就固定了,replica shard的数量可以随 时修改。
primary shard的默认数量是1,replica默认是1,默认共有2个shard,1个primary shard、 1replica shard。
注意:es7以前primary shard的默认数量是5,replica默认是1,默认有10个shard,5个primary shard,5个replica shard。
primary shard不能和自己的replica shardi放在同一个节点上(否则节点宕机, primary shard和副本都丢失,起不到容错的作用),但是可以和其他primary shard的replica shard放在同一个节点上。
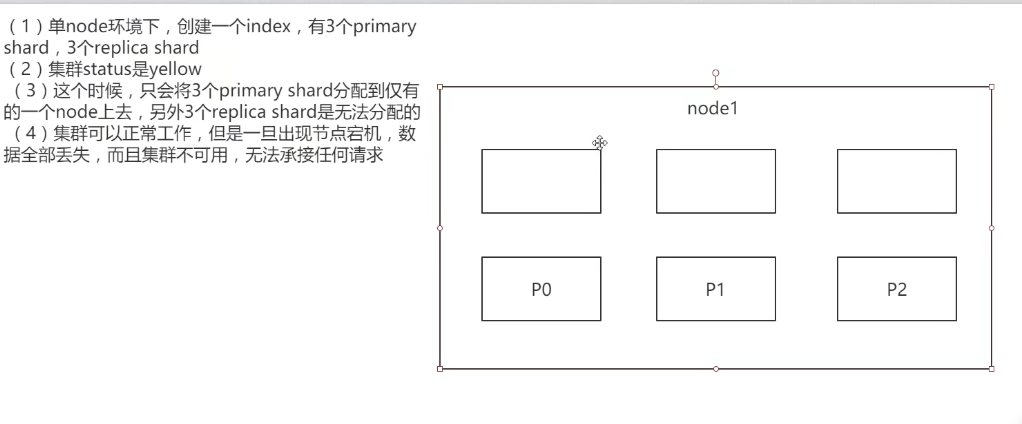
图解单node环境下创建index是什么样子的
- 单node环境下,创建一个index,有3个primary shard,3个replica shard。
- 集群status是yellow。
- 这个时候,只会将3个primary shard:分配到仅有的一个node上去,另外3个 replica shard是无法分配的。
- 集群可以正常工作,但是一旦出现节点宕机,数据全部丢失,而且集群不可用, 无法承接任何请求。
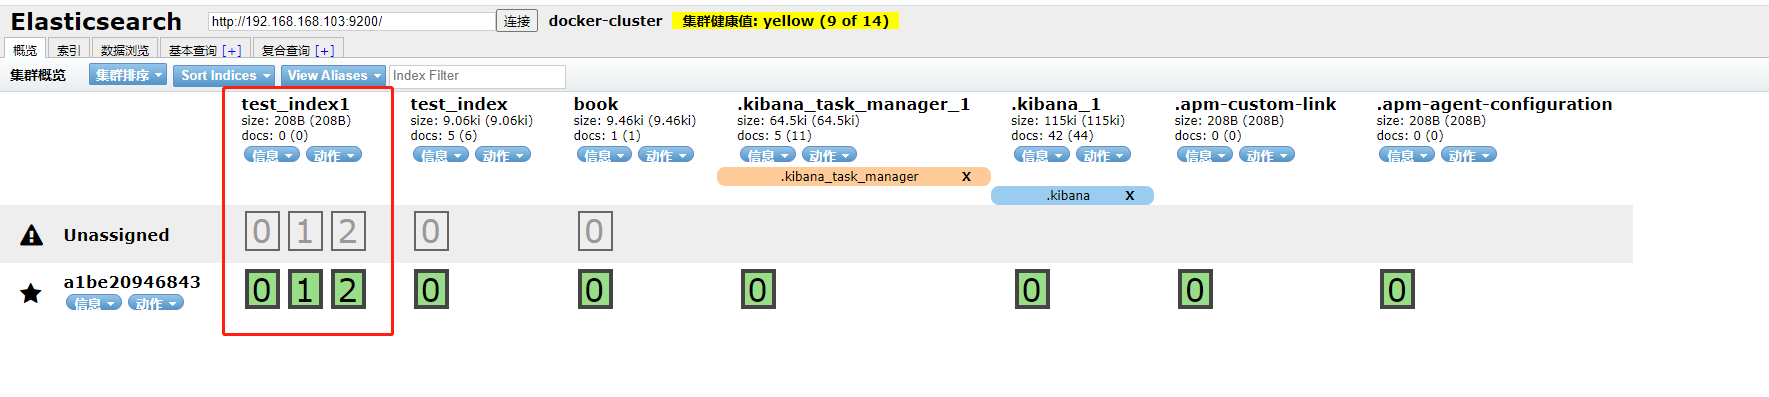
请求创建索引并设置分片值:
PUT /test_index1
{
    "settings": {
        "number_of_shards": 3,
        "number_of_replicas": 1
    }
}
响应结果:
{
  "acknowledged" : true,
  "shards_acknowledged" : true,
  "index" : "test_index1"
}
创建索引并设置分片值,插件可视化效果:
示例图
图解2个node环境下replica shard是如何分配的
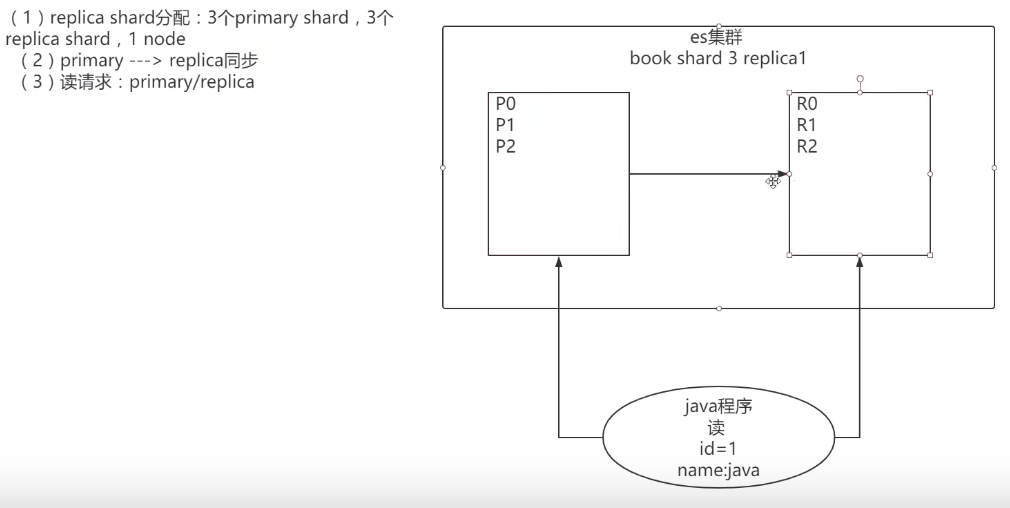
- replica shard分配:3个primary shard, 3个replica shard, 1 node。
- primary ---> replica同步。
- 读请求:primary/replica。
示例图
图解横向扩容
视频
- 分片自动负载均衡,分片向空闲机器转移。
- 每个节点存储更少分片,系统资源给与每个分片的资源更多,整体集群性能提高。
- 扩容极限:节点数大于整体分片数,则必有空闲机器。
- 超出扩容极限时,可以增加副本数,如设置副本数为2,总共3*3=9个分片。9台机器同时运行,存储和搜索性能更强、容错性更好。
- 容错性:只要一个索引的所有主分片在,集群就就可以运行。
示例图
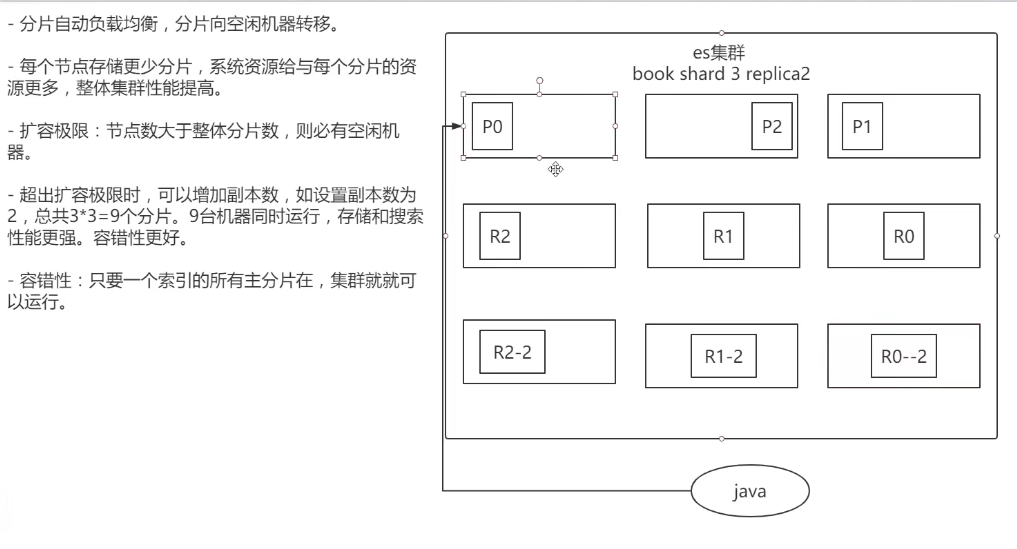
当前示例图最多可挂掉6台机器,确保P0、P1、P2可以存在即可,即为R副本可以在P挂掉时存在对应的副本R进行升级为P。
图解es容错机制masteri选举,replica容错,数据恢复
视频
day2-13- 图解es容错机制 master选举,replica容错,数据恢复_哔哩哔哩_bilibili
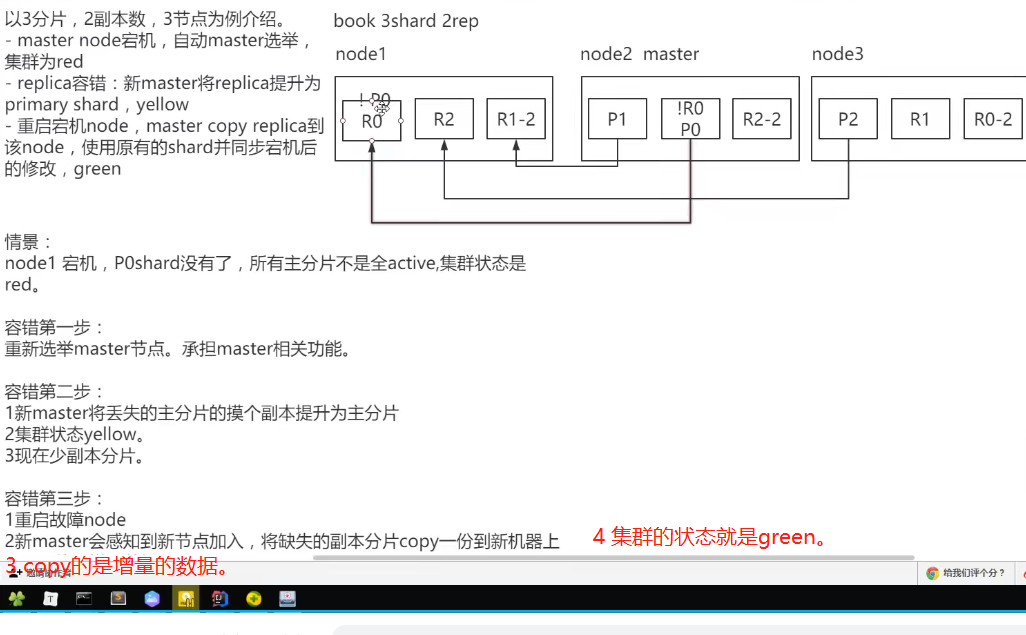
以3分片,2副本数,3节点为例介绍。
- master node:宕机,自动masteri选举,集群为red。
- replica容错:新master将replica提升为primary shard,yellow。
- 重启宕机node,master copy replica到该node,使用原有的shard并同步宕机后 的修改,green。
示例图
图解文档存储机制
9.1.数据路由
视频
9.1.1文档存储如何路由到相应分片
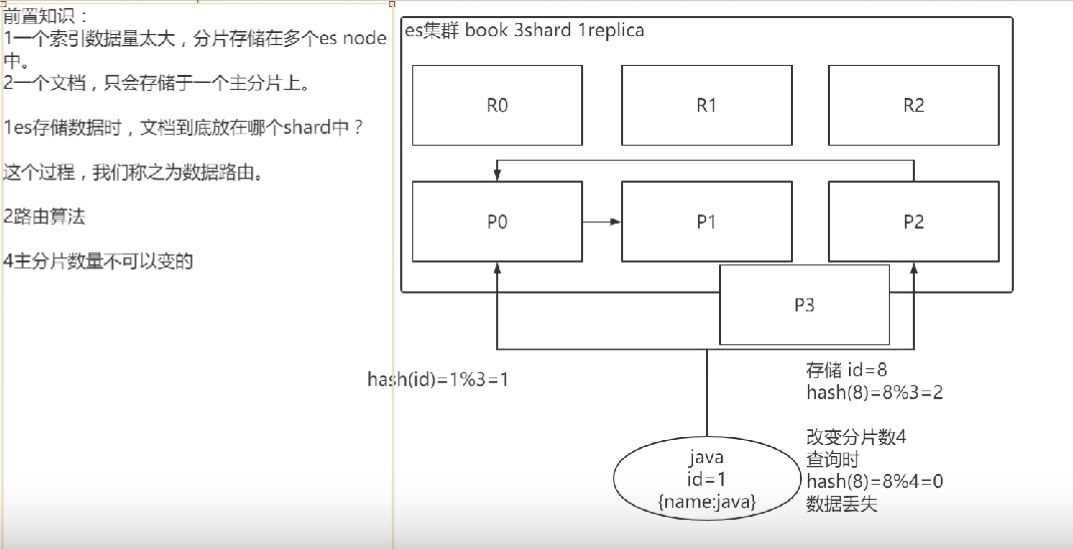
一个文档,最终会落在主分片的一个分片上,到底应该在哪一个分片?这就是数据
路由。
9.1.2路由算法
shard hash(routing)%number_of_primary_shards哈希值对主分片数取模。
举例:
对一个文档经行crud时,都会带一个路由值routing number。.默认为文档id(可能是
手动指定,也可能是自动生成)。
存储1号文档,经过哈希计算,哈希值为2,此索引有3个主分片,那么计算2%3=2,就算出此文档在P2分片上。
决定一个document在哪个shard.上,最重要的一个值就是routing值,默认是id,也
可以手动指定,相同的routing值,每次过来,从hash函数中,产出的hash值一定是
相同的。
无论hash值是几,无论是什么数字,对number of primary shards求余数,结果一
定是在0-number._of_primary_shards-1之间这个范围内的。0,1,2。
9.1.3手动指定routing key
PUT /test_index/_doc/157?routing=tom
{
    "username": "tom"
}
场景:在程序中,架构师可以手动指定已有数据的一个属性为路由值,好处是可以
定制一类文档数据存储到一个分片中。缺点是设计不好,会造成数据倾斜。
所以,不同文档尽量放到不同的索引中。剩下的事情交给s集群自己处理。
9.1.4主分片数星不可变
涉及到以往数据的查询搜索,所以一旦建立索引,主分片数不可变。
示例图
9.2.图解文档的增删改内部机制
视频
day2-15-图解文档的增删改内部机制_哔哩哔哩_bilibili
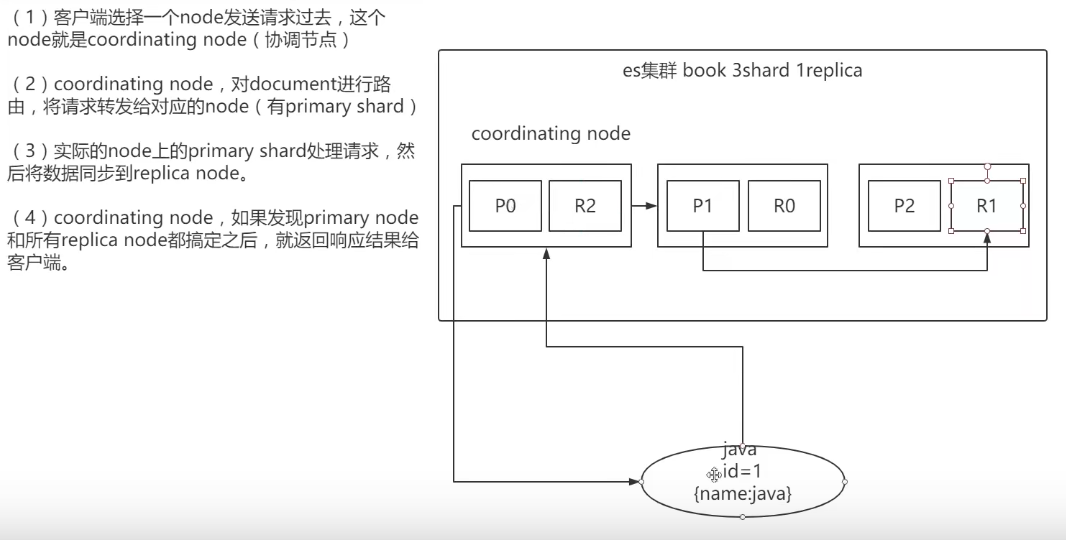
增删改可以看做update,都是对数据的改动。一个改动请求发送到es集群,经历以下
四个步骤:
- 客户端选择个node发送请求过去,这个node就是coordinating node(协调节 点)。
- coordinating node,对documenti进行路由,将请求转发给对应的node(有 primary shard)。
- 实际的node上的primary shard处理请求,然后将数据同步到replica node。
- coordinating node,如果发现primary node和所有replica node都搞定之后, 就返回响应结果给客户端。
示例图
9.3.图解文档的查询内部机制
视频
day2-16-图解文档的查询内部机制_哔哩哔哩_bilibili
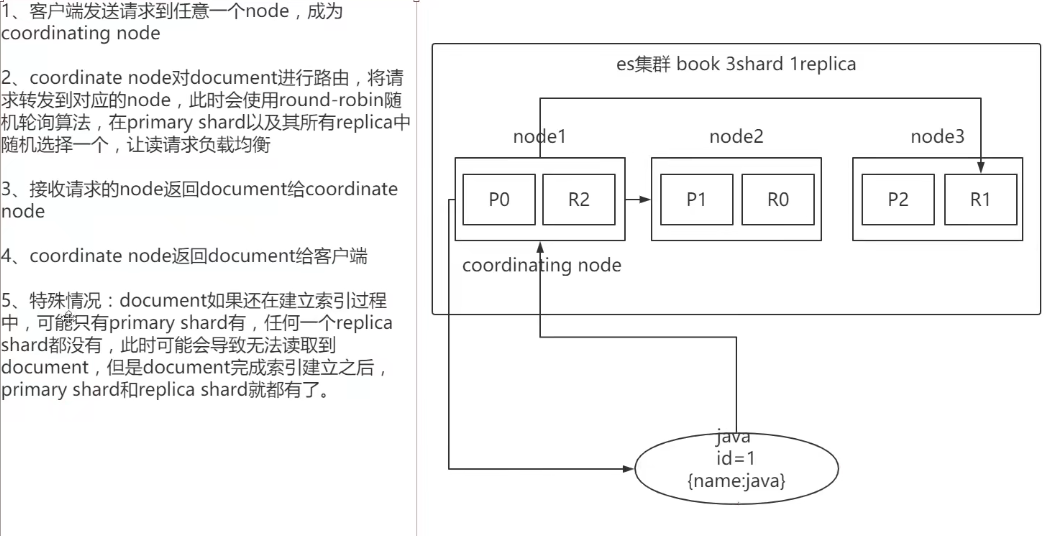
- 客户端发送请求到任意个node,成为coordinating node。
- coordinatingnode对documenti进行路由,将请求转发到对应的node,此时会使用round-robin随机轮询算法,在primary shard以及其所有replica中随机选择一个,让读请求负载均衡。
- 接收请求的node返回document给coordinatingnode。
- coordinatingnode返回document给客户端。
- 特殊情况:document如果还在建立索l过程中,可能只有primary shard有,任何一个replica shard都没有,此时可能会导致无法读取到document,但是document完成索建立之后,primary shard 和 replica shard就都有了。
示例图
9.4.bulk api奇特的json格式
POST /_bulk
{"action":{"meta"}}\n
{"data"}\n
{"action":{"meta"}}\n
{"data"}\n

// 正常的json应该如下,但是不符合es规范
[
    {
        "action": {
            "method": "create"
        },
        "data": {
            "id": 1,
            "fieldl": "java",
            "field2": "spring"
        }
    },
    {
        "action": {
            "method": "create"
        },
        "data": {
            "id": 2,
            "fieldl": "java",
            "field2": "spring"
        }
    }
]
bulk中的每个操作都可能要转发到不同的node的shard去执行。
如果采用比较良好的json数组格式。
允许任意的换行,整个可读性非常棒,读起来很爽,es拿到用那种标准格式的
json串以后,要按照下述流程去进行处理:
(1) 将json数组解析为JSONArray对像,这个时候,整个数据,就会在内存中出
现一份一模一样的拷贝,一份数据是json文本,一份数据是)SONArrayi对象;
(2) 解析ison数组里的每个json,对每个请求中的document进行路由;
(3) 为路由到同一个shard.上的多个请求,创建一个请求数组。100请求中有10个是到P1; (4) 将这个请求数组序列化;
(5) 将序列化后的请求数组发送到对应的节点上去;
耗费更多内存,更多的jvm gci开销。
我们之前提到过bulk size最佳大小的那个问题,一般建议说在几千条那样,然后
大小在10MB左右,所以说,可怕的事情来了。假设说现在100个buk请求发送
到了一个节点上去,然后每个请求是10MB,100个请求,就是1000MB=1GB,然
后每个请求的json都copy一份为jsonarray对象,此时内存中的占用就会翻倍,
就会占用2GB的内存,甚至还不止。因为弄成jsonarray之后,还可能会多搞一
些其他的数据结构,2GB+的内存占用。
占用更多的内存可能就会积压其他请求的内存使用量,比如说最重要的搜索请
求,分析请求,等等,此时就可能会导致其他请求的性能急速下降。
另外的话,占用内存更多,就会导致jva虚拟机的垃圾回收次数更多,更频繁,
每次要回收的垃圾对象更多,耗费的时间更多,导致es的java虚拟机停止工作线
程的时间更多。
现在的奇特格式
jsonPOST /_bulk {"delete":{"_index":"test_index","_id":"5"}}\n {"create":{"_index":"test_index","_id":"14"}}\n {"test_field":"test14"}\n {"update":{"_index":"test_index","_id":"2"}}\n {"doc":{"test_field":"bulk test"}}\n(1) 不用将其转换为json对象,不会出现内存中的相同数据的拷贝,直接按照换行符切割json;
(2) 对每两个一组的json,读取meta,进行document路由;
(3 )直接将对应的json发送到node上去;
最大的优势在于,不需要将json数组解析为一个)SONArrayi对象,形成一份大
数据的拷贝,浪费内存空间,尽可能地保证性能
10.Mapping映射入门
10.1.什么是mapping映射
概念:自动或手动为index中的_doc建立的一种数据结构和相关配置,简称为
mapping映射。
插入几条数据,让es自动为我们建立一个索引:
PUT /website/_doc/1
{
    "post_date": "2019-01-01",
    "title": "my first article",
    "content": "this is my first article in this website",
    "author_id": 11400
}

PUT /website/_doc/2
{
    "post_date": "2019-01-02",
    "title": "my second article",
    "content": "this is my second article in this website",
    "author_id": 11400
}

PUT /website/_doc/3
{
    "post_date": "2019-01-03",
    "title": "my third article",
    "content": "this is my third article in this website",
    "author_id": 11400
}
对比数据库建表语句
create table website(
	post_date date,
	title varchar(50),
	content varchar (100),
	author_id int(11)
);
动态映射:dynamic mapping,自动为我们建立index,以及对应mapping中包含了每
个field对应的数据类型,以及如何分词等设置。
重点:我们当然,后面会讲解,也可以手动在创建数据之前,先创建idex,以及对应
的mapping。
GET /website/_mapping响应结果:
{
  "website" : {
    "mappings" : {
      "properties" : {
        "author_id" : {
          "type" : "long"
        },
        "content" : {
          "type" : "text",
          "fields" : {
            "keyword" : {
              "type" : "keyword",
              "ignore_above" : 256
            }
          }
        },
        "post_date" : {
          "type" : "date"
        },
        "title" : {
          "type" : "text",
          "fields" : {
            "keyword" : {
              "type" : "keyword",
              "ignore_above" : 256
            }
          }
        }
      }
    }
  }
}
尝试各种搜索
GET /website/_search?q=2019 0条结果

GET /website/_search?q=2019-01-01 1条结果

GET /website/_search?q=post_date:2019-01-01 1条结果

GET /website/_search?q=post_date:2019 0条结果

GET /website/_search?q-third 1条结果

GET /website/_search?q=title:third 1条结果
搜索结果为什么不一致,因为es自动建立mapping的时候,设置了不同的field不同
的data type。
不同的data type的分词、搜索等行为是不一样的。所以出现了_all field和
post_date field的搜索表现完全不一样。
10.2.精确匹配与全文检索的对北比分析
10.2.1 exact value精确匹配
2019-01-01, exact value, 搜索的时候,必须输入2019-01-01,才能搜索出来
如果你输入一个01,是搜索不出来的。ype=date时,是精确匹配。
select from book where post date='2019-01-01'
10.2.2 full text全文检索
搜笔记电脑”,笔记本电脑词条会不会出现。
select*from book where name like'%笔记电脑%'
(1)缩写vs.全称:cnvs.china
(2)格式转化:like liked likes
(3)大小写:Tom vs tom
(4)同义词:like vs love
2019-01-01,20190101,搜索2019,或者01,都可以搜索出来
china,搜索cn,也可以将china搜索出来
likes,搜索ike,也可以将ikes搜索出来
Tom,搜索tom,也可以将Tom搜索出来
Iike,搜索love,同义词,也可以将ike搜索出来
就不是说单纯的只是匹配完整的一个值,而是可以对值进行拆分词语后(分词)进
行匹配,也可以通过缩写、时态、大小写、同义词等进行匹配。深入NPL,自然语义
处理。
10.3·全文检索下倒排索引核心原理快速揭秘
doc1 :I really liked my small dogs,and I think my mom also liked them.
doc2 :He never liked any dogs,so I hope that my mom will not expect me to liked him.
分词,初步的倒排索引的建立
| term | doc1 | doc2 |
|---|---|---|
| I | * | * |
| really | * | |
| liked | * | * |
| my | * | * |
| small | * | |
| dogs | * | |
| and | * | |
| think | * | |
| mom | * | * |
| also | * | |
| them | * | |
| He | * | |
| never | * | |
| any | * | |
| so | * | |
| hope | * | |
| that | * | |
| will | * | |
| not | * | |
| expect | * | |
| me | * | |
| to | * | |
| him | * |
演示了一下倒排索引最简单的建立的一个过程
搜索
mother like little dog,不可能有任何结果
mother
like
little
dog
这不是我们想要的结果。同义词mom\mother在我们人类看来是一样。想进行标
准化操作。
重建倒排索引
normalization正规化,建立倒排索引的时候,会执行一个操作,也就是说对拆分出
的各个单词进行相应的处理,以提升后面搜索的时候能够搜索到相关联的文档的概
率。
时态的转换,单复数的转换,同义词的转换,大小写的转换
mom ---> mother
liked ---> like
small ---> little
dogs ---> dog
重新建立倒排索引,加入normalization,再次用mother liked little dog搜索,就可以
搜索到了。
| term | doc1 | doc2 | normalization |
|---|---|---|---|
| I | * | * | |
| really | * | ||
| like | * | * | liked ---> like |
| my | * | * | |
| little | * | small ---> little | |
| dog | * | dogs ---> dog | |
| and | * | ||
| think | * | ||
| mother | * | * | mom ---> mother |
| also | * | ||
| them | * | ||
| He | * | ||
| never | * | ||
| any | * | ||
| so | * | ||
| hope | * | ||
| that | * | ||
| will | * | ||
| not | * | ||
| expect | * | ||
| me | * | ||
| to | * | ||
| him | * |
重新搜索
搜索:mother liked little dog, 对搜索条件经行分词normalization
mother
liked-》like
little
dog
doc1和doc2都会搜索出来!
10.4.分词器analyzer
10.4.1 什么是分词器analyzer
作用:切分词语,normalization(提升recall召回率)
给es一段句子,然后将这段句子拆分成一个一个的单个的单词,同时对每个单词进
行normalization(时态转换,单复数转换)
recall,召回率:搜索的时候,增加能够搜索到的结果的数量
analyzer 3个组成部分、步骤:
character filter:在一段文本进行分词之前,先进行预处理,比如说最常见的就
是,过滤html标签(
<span>hello<span>->hello), &->and ( l&you ---> I and you)。tokenizer:分词,hello you and me- --> hello,you,and,me。
token filter lowercase stop word synonymom dogs ---> dog,liked --->
like,Tom ---> tom,a/the/an->干掉,mother ---> mom,small ---> little
stop word 停用词:了 的 呢。
一个分词器,很重要,将一段文本进行各种处理,最后处理好的结果才会拿去建立
倒排索引。
10.4.2 内置分词器的介绍
例句:Set the shape to semi--transparent by calling set_trans(S)
standard analyzer标准分词器:set,the,shape,to,semi,transparent,,by,calling,set_trans,5(默认的是standard)
simple analyzeri简单分词器:set,the,shape,to,semi,transparent,by,calling,set,trans
whitespace analyzer Set,the,shape,to,semi-transparent,by,calling,set_trans(5)
language analyzer(特定的语言的分词器,比如说,english,英语分词器):set,shape,semi,transpar,call,set_tran,5
官方文档地址:
[Built-in analyzer reference | Elasticsearch Guide 7.7] | Elastic
10.5.query string根据字段分词策略
10.5.1 query string:分词
query string必须以和index建立时相同的analyzeri进行分词
query string对exact value和full text的区别对待
如:date:exact value精确匹配
text:full text全文检索
10.5.2测试分词器
GET /_analyze
{
    "analyzer": "standard",
    "text": "Text to analyze 70"
}
响应结果:
{
  "tokens" : [
    {
      "token" : "text",
      "start_offset" : 0,
      "end_offset" : 4,
      "type" : "<ALPHANUM>",
      "position" : 0
    },
    {
      "token" : "to",
      "start_offset" : 5,
      "end_offset" : 7,
      "type" : "<ALPHANUM>",
      "position" : 1
    },
    {
      "token" : "analyze",
      "start_offset" : 8,
      "end_offset" : 15,
      "type" : "<ALPHANUM>",
      "position" : 2
    },
    {
      "token" : "70",
      "start_offset" : 16,
      "end_offset" : 18,
      "type" : "<NUM>",
      "position" : 3
    }
  ]
}