 Redis-AI整理版
基于 Redis 重新整理。
目标不是“把原文再说一遍”,而是把内容改成更适合学习、复习、回看的笔记结构。
这份笔记怎么读
原文把整段官方文档塞在表格单元格里,本整理版把每个数据类型重排为“速查表 + 关键命令详解 + 应用场景”。建议先过五大数据类型,再看分布式锁与淘汰策略,最后手写一遍 LRU。
学习路线图
| 阶段 | 重点 | 说明 |
|---|---|---|
| 入门 | 五大数据类型 | 会用常用命令,知道各自的应用场景 |
| 进阶 | 分布式锁 | setnx 的原子性与看门狗续期 |
| 进阶 | 过期与淘汰策略 | “2 个维度、4 个方面”和三大过期删除策略 |
| 手写 | LRU 算法 | 用 Map + 双向链表实现一遍 |
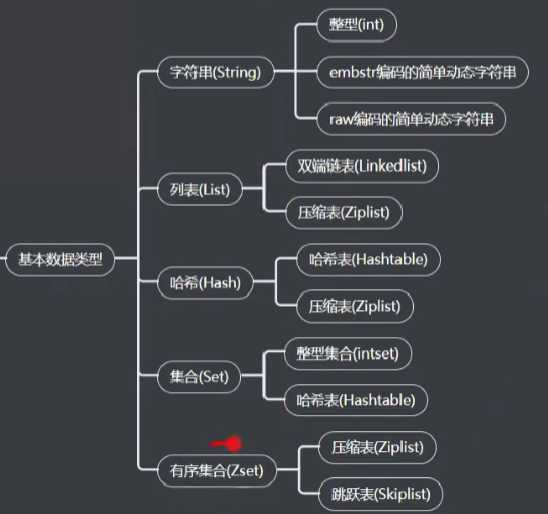
一、基本数据结构总览
二、string
1. 速查表
| 命令 | 作用 |
|---|---|
| SET key value [EX seconds] [PX milliseconds] [NX|XX] | 将字符串值 value 关联到 key |
| GET key | 返回与键 key 相关联的字符串值 |
| STRLEN key | 返回键 key 储存的字符串值的长度 |
| INCR key | 为键 key 储存的数字值加上一 |
| DECR key | 为键 key 储存的数字值减去一 |
2. 关键命令详解
SET:
- key 已持有其他值时直接覆写旧值,无视类型;对带有 TTL 的键设置后,原有的 TTL 被清除
- 可选参数(Redis 2.6.12 起):
EX seconds秒级过期(等同 SETEX)、PX milliseconds毫秒级过期(等同 PSETEX)、NX只在键不存在时设置(等同 SETNX)、XX只在键已存在时设置 - 返回值:设置成功返回 OK;使用了 NX/XX 但条件不满足时返回空批量回复(NULL Bulk Reply)
- 因为 SET 的参数可以覆盖 SETNX、SETEX、PSETEX 的效果,将来的版本可能会废弃这三个命令
GET:键不存在返回 nil;值并非字符串类型返回错误。STRLEN:键不存在返回 0;不是字符串值返回错误。
INCR / DECR:
- 键不存在时先初始化为 0 再操作;值不能解释为数字时返回错误;限制在 64 位有符号数字之内
- INCR 是针对字符串的操作:Redis 没有专用的整数类型,执行时值会被解释为十进制 64 位有符号整数
- 返回执行操作之后的值
3. 应用场景
- 分布式锁(setnx)
- 递增、递减(点赞数,只是统计被点赞总数)
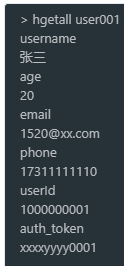
三、hash
对应 Java 的 Map<String, Map<K, V>> 结构。
1. 速查表
| 命令 | 作用 |
|---|---|
| HSET hash field value | 将哈希表 hash 中域 field 的值设置为 value |
| HGET hash field | 返回哈希表中给定域的值 |
| HMSET key field value [field value …] | 同时将多个域-值对设置到哈希表 key 中 |
| HMGET key field [field …] | 返回哈希表 key 中一个或多个给定域的值 |
| HGETALL key | 返回哈希表 key 中所有的域和值 |
| HLEN key | 返回哈希表 key 中域的数量 |
| HDEL key field [field …] | 删除哈希表 key 中一个或多个指定域 |
| HEXISTS hash field | 检查给定域 field 是否存在于哈希表 hash 当中 |
2. 关键命令详解
- HSET:哈希表不存在时先创建再操作;域 field 已存在时旧值被新值覆盖
- HMSET:同时设置多个域-值对,会覆盖已存在的域;key 不存在时先创建空哈希表
- HMGET:不存在的域返回 nil;不存在的 key 被当作空哈希表处理
- HGETALL:返回值里每个域名之后紧跟域的值,所以返回值长度是哈希表大小的两倍
- HDEL:不存在的域将被忽略;HEXISTS:存在返回 1,不存在返回 0
3. 应用场景
购物车场景,存储用户基础信息。
四、list
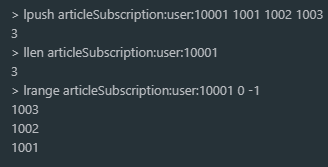
list 是有序的,且可以重复。
1. 速查表
| 命令 | 作用 |
|---|---|
| LLEN key | 返回列表 key 的长度 |
| LPOP key | 移除并返回列表 key 的头元素 |
| LREM key count value | 根据参数 count 移除列表中与 value 相等的元素 |
| LPUSH key value [value …] | 将一个或多个值 value 插入到列表 key 的表头 |
| RPUSH key value [value …] | 将一个或多个值 value 插入到列表 key 的表尾(最右边) |
| LPUSHX key value | 仅当 key 存在且是列表时,将 value 插入表头 |
| RPUSHX key value | 仅当 key 存在且是列表时,将 value 插入表尾 |
2. 关键命令详解
- LPUSH / RPUSH:多个 value 从左到右依次插入表头/表尾。对空列表执行
LPUSH mylist a b c结果是c b a,RPUSH mylist a b c结果是a b c。key 不存在时先创建空列表再操作;key 不是列表类型时返回错误 - LPUSHX / RPUSHX:与 LPUSH / RPUSH 相反,当 key 不存在时什么也不做
- LREM 的 count:count > 0 从表头向表尾移除 count 个;count < 0 从表尾向表头移除 |count| 个;count = 0 移除所有与 value 相等的值
- LLEN:key 不存在时按空列表处理返回 0;不是列表类型返回错误
3. 应用场景
微信文章订阅公众号。
五、set
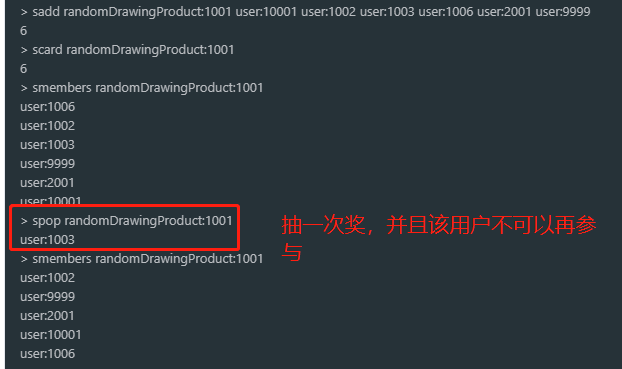
集合,不可重复。
1. 速查表
| 命令 | 作用 |
|---|---|
| SADD key member [member …] | 将一个或多个 member 元素加入到集合 key 当中 |
| SREM key member [member …] | 移除集合 key 中的一个或多个 member 元素 |
| SMEMBERS key | 返回集合 key 中的所有成员 |
| SISMEMBER key member | 判断 member 元素是否是集合 key 的成员 |
| SCARD key | 返回集合 key 的基数(元素数量) |
| SRANDMEMBER key [count] | 返回集合中的一个或多个随机元素(不移除) |
| SPOP key | 移除并返回集合中的一个随机元素 |
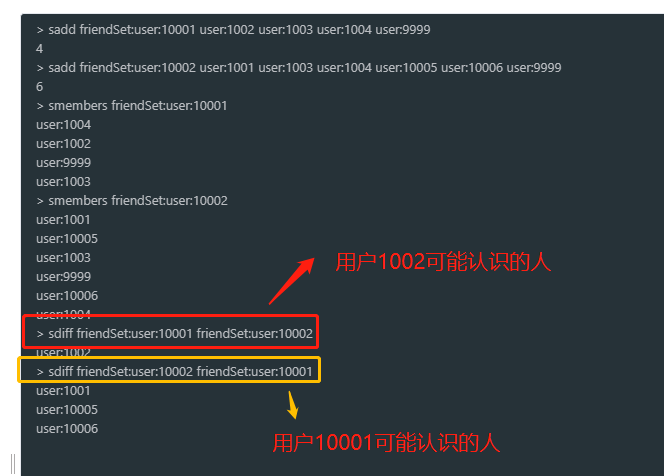
| SDIFF key [key …] | 返回所有给定集合之间的差集 |
2. 关键命令详解
- SADD:已存在的 member 会被忽略;key 不存在时先创建集合;不是集合类型返回错误。SREM:不存在的 member 会被忽略
- SMEMBERS:不存在的 key 被视为空集合。SISMEMBER:是成员返回 1,不是或 key 不存在返回 0
- SRANDMEMBER:只给 key 时返回一个随机元素;count 为正且小于基数时返回 count 个互不相同的元素,大于等于基数时返回整个集合,为负时返回可能重复、长度为 |count| 的数组。它只返回不移除
- SPOP:移除并返回一个随机元素,key 不存在或空集时返回 nil。SDIFF:返回差集成员列表,不存在的 key 视为空集
3. 应用场景
- 随机抽奖小程序
- 微信朋友圈点赞
- 微博好友关注的社交关系(使用 SINTER key 获取交集)
- QQ 推荐可能认识的人(使用 SDIFF key 获取差集)
QQ 推荐可能认识的人(注意:这里把好友本身算进去了,实际需要去除):
六、zset
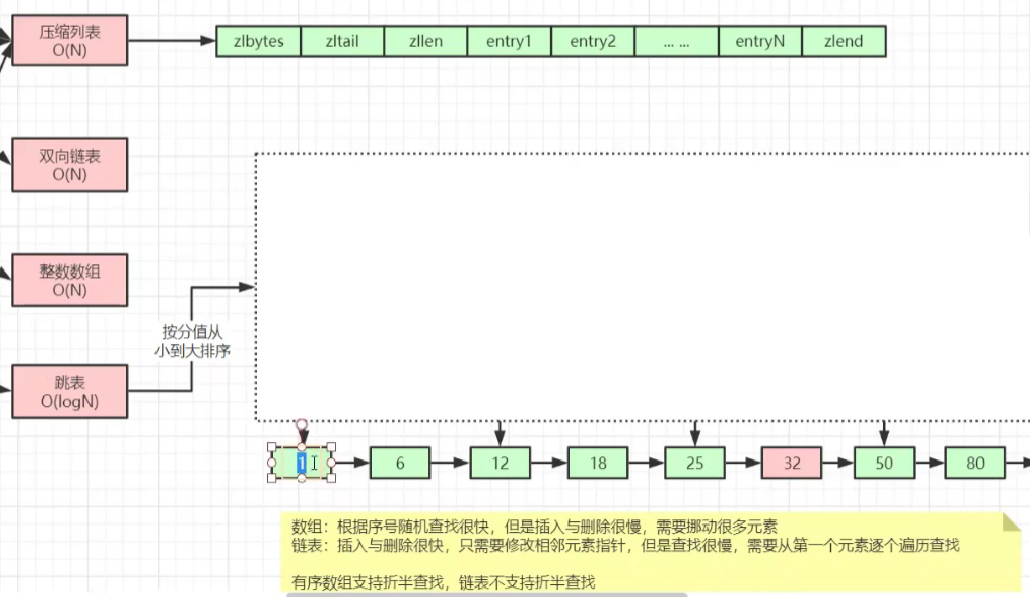
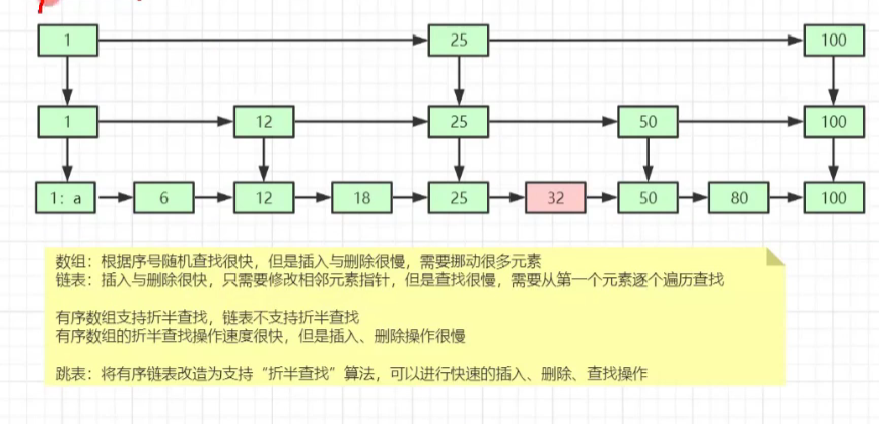
有序集合,不可重复。在有序集合中加入了一个元素和该元素的分数。object encoding key 是压缩列表(ziplist,O(N))和跳表(skiplist,O(logN))。
1. 速查表
| 命令 | 作用 |
|---|---|
| ZADD key score member [[score member] …] | 将一个或多个 member 元素及其 score 值加入到有序集 key 当中 |
| ZRANGE key start stop [WITHSCORES] | 返回有序集 key 中指定区间内的成员(按 score 递增) |
| ZSCORE key member | 返回有序集 key 中成员 member 的 score 值 |
| ZREM key member [member …] | 移除有序集 key 中的一个或多个成员 |
| ZRANGEBYSCORE key min max [WITHSCORES] [LIMIT offset count] | 返回 score 值介于 min 和 max 之间的成员 |
| ZINCRBY key increment member | 为成员 member 的 score 值加上增量 increment |
| ZCARD key | 返回有序集 key 的基数 |
| ZCOUNT key min max | 返回 score 值在 min 和 max 之间的成员数量 |
2. 关键命令详解
- ZADD:member 已是有序集成员时更新 score,并通过重新插入保证它在正确的位置上;score 可以是整数或双精度浮点数;key 不存在时先创建空的有序集
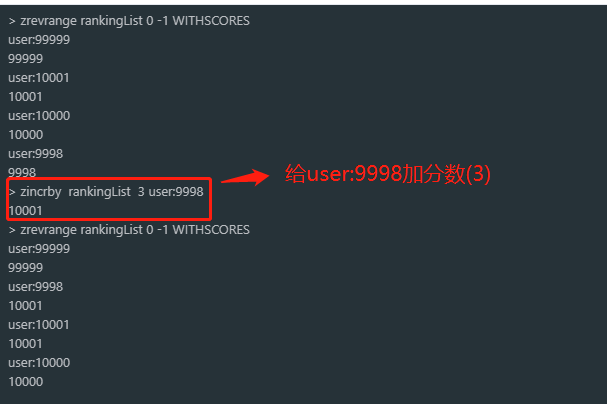
- ZRANGE:按 score 递增排列,相同 score 按字典序;下标以 0 为底,可用负数(-1 表示最后一个成员);超出范围的下标不报错;需要递减时用 ZREVRANGE;WITHSCORES 让成员和 score 一并返回(value1, score1, ..., valueN, scoreN)
- ZRANGEBYSCORE:返回 score 介于 min 和 max 之间(默认闭区间)的成员;给参数前加
(可用开区间;min/max 可以是-inf和+inf;LIMIT 参数类似 SQL 的SELECT LIMIT offset, count,offset 很大时定位可能要遍历整个有序集,最坏 O(N) - ZINCRBY:传负数 increment 即做减法;key 不存在或 member 不是成员时等同于 ZADD;返回新 score 值(字符串形式)
3. 应用场景
- 根据商品的销售进行排序
- 点赞排行榜的排序
- 战力榜排序
七、Redis 分布式锁
1. 什么是分布式锁
分布式微服务架构拆分后,各个微服务之间为了避免冲突和数据故障而加入的一种锁。可以用 mysql、zookeeper、redis(setnx)实现,一般常用的是 redis 分布式锁。
2. redis 做分布式锁要注意的问题
- redis.setnx 的时候需要注意原子性
- redis.del 的时候需要注意原子性,确保删除的是该线程持有的锁,一般采用 lua 脚本实现(官网推荐)
- setnx 时设置了过期时间,可能存在过期时间结束了线程还未执行结束的情况,这时其他线程可以获得锁。可以在获取锁的线程后台启动一个守护线程,每次快到过期时间时重置过期时间
3. 常见追问
- redis 单点部署会带来什么问题、怎么解决?参考 Redis 单机部署常见问题以及生产环境下的优化和安全设置
- 主从集群模式下有没有什么问题?参考 Redis 主从集群常见的问题有哪些? - 知乎
- 简单介绍一下 Redlock?简历上写了 redisson 怎么描述?参考 Redisson 分布式锁源码 09:RedLock 红锁的故事
4. redis 分布式锁如何续期(看门狗)
通过守护线程“看门狗”,每隔 10s(internalLockLeaseTime / 3)检查业务是否完成,未结束就续期,每次续命值默认为 30s(internalLockLeaseTime)。
看门狗是个守护线程,必须有线程守护:服务宕机时守护线程关闭、不再续期,key 直到过期失效。
不用 lua 脚本的话,还可以使用事务。
八、缓存过期与淘汰策略
1. maxmemory 相关
- maxmemory 设置为 0 或未设置时:64 位系统下不限制内存大小,32 位系统下最多使用 3GB;默认配置为 0
- redis 内存设置一般推荐为最大物理内存的四分之三
- 常用命令:
config get maxmemory查看最大限制内存、config set maxmemory 1设置、info memory查看内存信息 - 修改方式:改配置文件的 maxmemory 属性,或
config set maxmemory value
内存满了再执行 set k1 v1 会抛出:OOM command not allowed when used memory > 'maxmemory'.
2. redis 缓存淘汰策略(8 种)
| 策略 | 说明 |
|---|---|
| volatile-lru | 对所有设置了过期时间的 key 使用 LRU 算法进行删除 |
| allkeys-lru | 对所有 key 使用 LRU 算法进行删除 |
| volatile-lfu | 对所有设置了过期时间的 key 使用 LFU 算法进行删除 |
| allkeys-lfu | 对所有 key 使用 LFU 算法进行删除 |
| volatile-random | 对所有设置了过期时间的 key 使用随机删除 |
| allkeys-random | 对所有的 key 使用随机删除 |
| volatile-ttl | 删除马上要过期的 key(TTL 最小的) |
| noeviction | 不驱逐任何 key,写操作直接返回错误 |
- LRU means Least Recently Used(最近最少使用);LFU means Least Frequently Used(最常用)
- 记忆框架:2 个维度(过期键中筛选 / 所有键中筛选)x 4 个方面(lru / lfu / 随机 / ttl)
- 实际最常用 allkeys-lru;没有配置 MAXMEMORY POLICY 时默认为 noeviction
3. 三大过期删除策略
一个键到了过期时间之后,不会马上从内存中删除,redis 采用的是:
- 定时删除:对 CPU 不友好,用处理器性能换取存储空间(时间换空间)
- 惰性删除:数据达到过期时间后,下次调用再进行删除,会造成大量无效数据,除非 FLUSHDB(空间换时间)
- 定期删除:每隔一段时间执行一次删除过期键操作,并限制删除操作的时长和频率来减少对 CPU 时间的影响
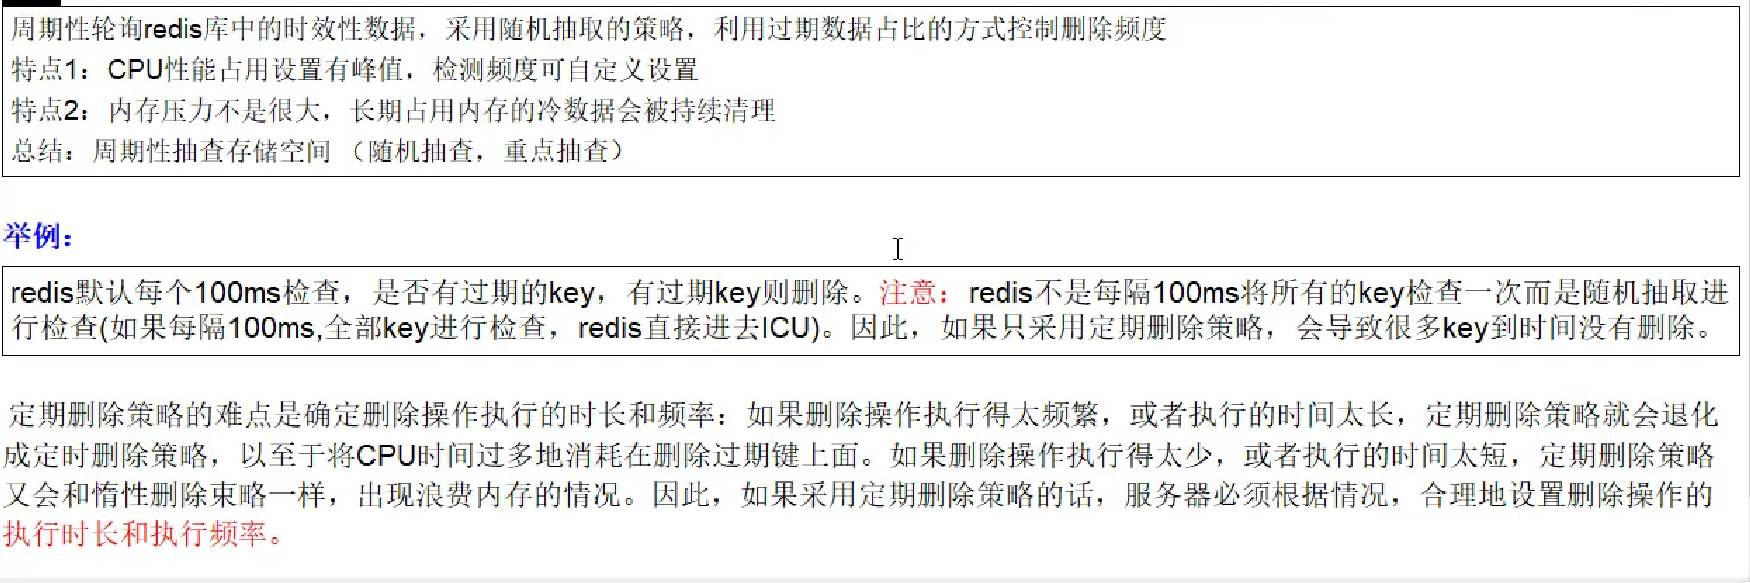
即使这样还是会有“漏网之鱼”,所以出现了淘汰策略。
九、LRU 算法的手写实现
思路:1. 参考 LinkedHashMap 实现;2. 使用 Map 加 Node(双向链表)实现。
第二种思路(Map 负责 O(1) 查找,双向链表维护新旧顺序:新节点放头部,满了淘汰尾部):
package com.blacktea.redisson;

import lombok.extern.slf4j.Slf4j;

import java.util.HashMap;
import java.util.Map;

@Slf4j
public class MyLruDemo {

    /**
     * Node节点,作为数据的载体
     */
    static class Node<K, V> {
        Node<K, V> prev;
        Node<K, V> next;
        V value;
        K key;

        public Node(K key, V value) {
            this.prev = this.next = null;
            this.value = value;
            this.key = key;
        }

        public Node() {
            this.prev = this.next = null;
        }
    }

    /**
     * 双向链表,里面的数据就是我们的Node
     */
    class DoubleLinkedList<K, V> {
        Node<K, V> head;
        Node<K, V> tail;

        public DoubleLinkedList() {
            head = new Node<>();
            tail = new Node<>();
            head.next = tail;
            tail.prev = head;
        }

        public void addHead(Node<K, V> node) {
            node.next = head.next;
            node.prev = head;
            head.next.prev = node;
            head.next = node;
        }

        public void removeNode(Node<K, V> node) {
            node.next.prev = node.prev;
            node.prev.next = node.next;
            node.prev = null;
            node.next = null;
        }

        public Node<K, V> getLast() {
            return tail.prev; // 尾结点是虚拟节点
        }
    }

    private int cacheSize;
    Map<Integer, Node<Integer, Integer>> map;
    DoubleLinkedList<Integer, Integer> doubleLinkedList;

    public MyLruDemo(int cacheSize) {
        this.cacheSize = cacheSize;                       // 缓存长度
        this.map = new HashMap<>();                       // 查找 hash
        this.doubleLinkedList = new DoubleLinkedList<>(); // 双向链表
    }

    public int get(int key) {
        if (!map.containsKey(key)) {
            return -1;
        }
        // 将Node放到队列头部
        Node<Integer, Integer> node = map.get(key);
        doubleLinkedList.removeNode(node);
        doubleLinkedList.addHead(node);
        return node.value;
    }

    public void put(int key, int value) {
        Node<Integer, Integer> node;
        if (map.containsKey(key)) {
            node = map.get(key);
            doubleLinkedList.removeNode(node);
            node.value = value;
        } else {
            node = new Node<>(key, value);
            if (map.size() == cacheSize) {
                // 缓存长度达到,淘汰链表尾部
                Node<Integer, Integer> lastNode = doubleLinkedList.getLast();
                map.remove(lastNode.key);
                doubleLinkedList.removeNode(lastNode);
            }
        }
        map.put(key, node);
        doubleLinkedList.addHead(node); // 添加到队列头
    }

    public static void main(String[] args) {
        MyLruDemo lru = new MyLruDemo(3);
        lru.put(1, 1);
        lru.put(2, 2);
        lru.put(3, 3);
        lru.put(4, 4); // 淘汰最久未使用的 1
        lru.put(3, 3); // 3 移到头部
        lru.put(5, 1); // 淘汰 2
    }
}
十、分布式锁 lua 脚本
加锁脚本(hash 结构 + 可重入计数的写法):
if (redis.call('exists', KEYS[1]) == 0)
    then redis.call('hincrby', KEYS[1], ARGV[2], 1);
    redis.call('pexpire', KEYS[1], ARGV[1]);
    return nil;
end;
if (redis.call('hexists', KEYS[1], ARGV[2]) == 1)
    then redis.call('hincrby', KEYS[1], ARGV[2], 1);
    redis.call('pexpire', KEYS[1], ARGV[1]);
    return nil;
end;
return redis.call('pttl', KEYS[1]);
十一、一页总结
- string:SET 的 EX/PX/NX/XX 参数一个命令覆盖 SETEX/PSETEX/SETNX,适合计数和分布式锁
- hash:对应 Map<String, Map<K, V>>,适合存对象(购物车)
- list:有序可重复,LPUSH/RPUSH 两头进出,适合订阅消息流
- set:不可重复,SINTER 交集做共同关注、SDIFF 差集做可能认识的人
- zset:带分数的有序集合,ziplist/skiplist 两种编码,做各种排行榜
- 分布式锁:setnx 原子性 + lua 删锁 + 看门狗续期(10s 检查、30s 续命)
- 淘汰策略:2 维度 x 4 方面共 8 种,最常用 allkeys-lru,默认 noeviction
- 过期删除:定时、惰性、定期组合使用,仍有漏网之鱼所以需要淘汰策略
- LRU 手写:Map + 双向链表,访问即移到头部,满了淘汰尾部